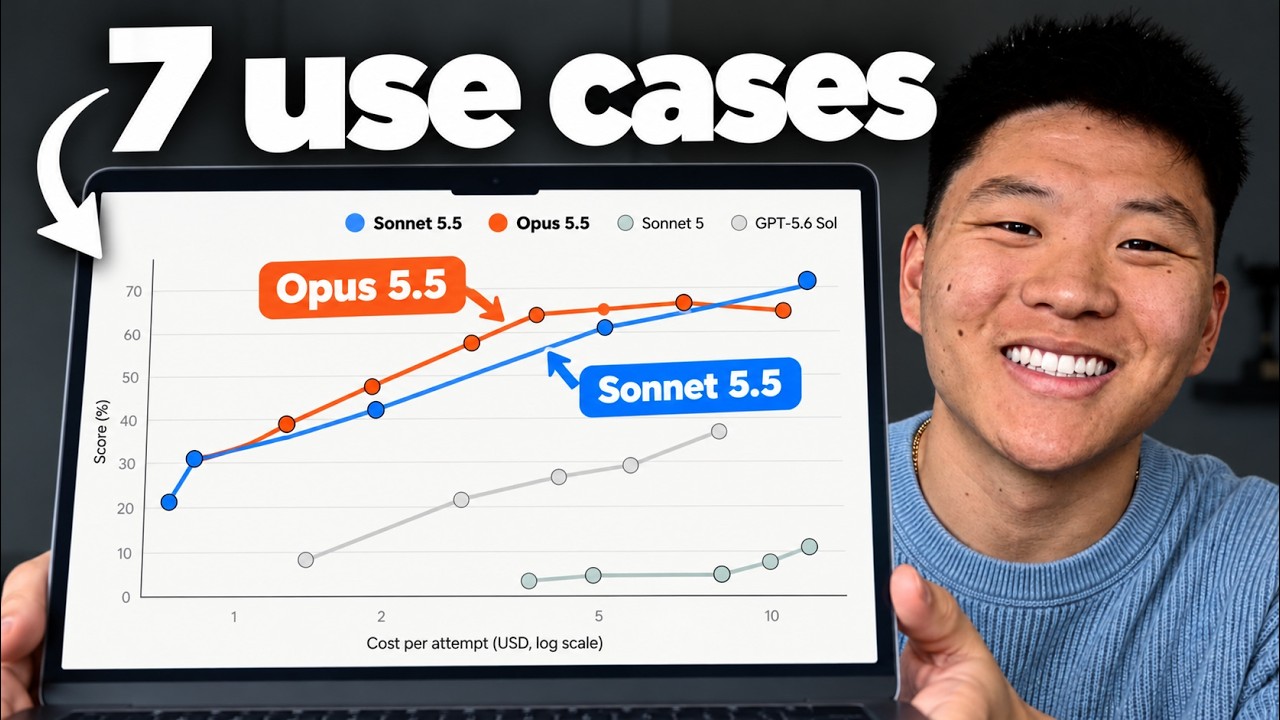
I Tested Sonnet 5.5 vs Opus 5.5. What You Need to Know.
J'ai testé Sonnet 5.5 contre Opus 5.5. Ce que vous devez savoir.
Mots-clés
Résumé
149 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
L’apport principal réside dans la mise en situation réelle et chiffrée des deux modèles, avec des coûts calculés, des durées d’exécution et des comparaisons visuelles des sorties. L’argumentation est structurée en sept cas concrets, ce qui donne un aperçu pratique des forces de chaque modèle. La logique de sélection est explicite : plus la tâche est spécifiée, plus Sonnet devient avantageux ; plus elle est ouverte, plus Opus se justifie. Toutefois, l’évaluation de la qualité des outputs est largement subjective, basée sur le goût personnel de l’auteur, sans critères objectifs préétablis (typographie, lisibilité, taux de conversion). Les coûts sont calculés sur l’API, mais l’auteur note lui-même que la corrélation avec les abonnements est approximative. La démarche reste empirique et informative, mais sans rigueur statistique ni contrôle d’experts indépendants.
Rigueur scientifique, qualité des sources, adéquation du titre
La vidéo ne cite aucune source externe scientifique ; seules des ressources promotionnelles (skill ScrollCraft, outils Glaido, Hostinger) et des liens personnels sont mentionnés. Les affirmations sur les capacités des modèles reposent uniquement sur les tests effectués, avec un échantillon très réduit (sept cas). Les données chiffrées (tokens, coût) semblent plausibles et cohérentes avec les tarifs annoncés sur le site d’Anthropic, mais elles ne sont pas vérifiées par une source indépendante. Le titre reflète fidèlement le contenu, sans exagération notable. Le niveau de détail technique est correct pour un public déjà initié, mais ne fournit pas de référence vérifiable pour approfondir. Les commentaires utilisateurs ne sont pas analysés, car aucun n’est fourni.
255 mots
Adéquation titre / contenu
Le titre annonce exactement une comparaison pratique de deux modèles, et le contenu s'y conforme en détail.
Qualité & fiabilité
6/10
Le test repose sur des mesures concrètes de coût, durée et sorties, mais la sélection des cas est restreinte, l'évaluation qualitative est subjective et la méthodologie (prompts identiques, environnement non décrit) demeure peu contrôlée. Les transcriptions présentent des erreurs, mais la vidéo en elle-même est claire et reproductible.
Chapitres
Sources citées
- Scrollcraft Website Design Skill — Ressource gratuite proposée par l'auteur dans la description, utilisée comme exemple de skill pour générer des sites web.
- Glaido (Voice to text) — Outil sponsorisé mentionné dans la description, cité comme outil de transcription vocale.
- Hostinger VPS pour Claude Code — Hébergement VPS sponsorisé, présenté comme solution pour exécuter Claude Code en continu.
- AI Automation Society (Skool) — Communauté en ligne de l'auteur, mentionnée pour accéder à des ressources supplémentaires.
- Profil LinkedIn de l'auteur — Page de contact et de partage de contenu de l'auteur.
Références externes
Apport & nouveautés
L’apport original est de fournir une comparaison terrain, chiffrée et orientée usage, entre deux modèles d’IA générative, dans des scénarios représentatifs de la production de contenus et de documents. La vidéo donne des repères concrets (coûts, temps) pour choisir un modèle selon le degré de spécification de la tâche, ce qui peut éclairer les praticiens de l’IA.
Pour aller plus loin :
- Claude (modèle d’IA) — Wikipédia — Contexte sur les modèles Claude d’Anthropic.
- Large language model — Wikipédia — Fondement des modèles de langage utilisés.
- Prompt engineering — Wikipédia — Principes pour formuler les instructions, en lien avec les observations sur la spécification des tâches.
- AI alignment — Wikipédia — Question sous-jacente à la qualité des réponses, pertinente pour évaluer la fiabilité des sorties.
125 mots
Profil radar
Le profil radar montre une quantité d'information modérée à élevée, une qualité jugée correcte, un niveau technique moyen et une fiabilité globale moyenne. La vidéo est informative et pertinente pour un public professionnel, mais ses limites méthodologiques réduisent sa solidité.