[ИАД, осень 2026] Вероятностные тематические модели 1
[IAD, automne 2026] Modèles thématiques probabilistes 1
Mots-clés
Résumé
159 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
La valeur pédagogique est élevée : le cours est clair, bien structuré et s’appuie sur une longue expérience du sujet. L’argumentation est solide, le professeur justifie chaque hypothèse et montre comment les problèmes sont reformulés mathématiquement. Il insiste sur l’utilité des modèles probabilistes pour des applications pratiques tout en soulignant leurs limites. La transition vers des approches basées sur l’optimisation et les réseaux de neurones est présentée comme une évolution naturelle, bien motivée.
Rigueur scientifique, qualité des sources, adéquation du titre
Le cours est rigoureux sur le plan mathématique, avec une introduction claire des notations et des hypothèses. Les sources sont implicites : le professeur mentionne des modèles comme word2vec, LDA, BERT, GPT, sans donner de références détaillées. Le titre est fidèle au contenu, même si le cours semble s’orienter vers une perspective plus large incluant les modèles de langue. La rigueur est soutenue par une présentation formelle des concepts et une mise en garde sur les limites des approches classiques. L’adéquation titre/contenu est correcte, même si la promesse du cours va au-delà des modèles purement probabilistes, ce qui justifie le sous-titre alternatif mentionné en début de leçon.
195 mots
Adéquation titre / contenu
Le titre annonce un cours sur les modèles thématiques probabilistes, le contenu est conforme, premier cours d'une série.
Qualité & fiabilité
8/10
Cours universitaire avancé, exposé structuré, références à des modèles reconnus, mais pas de sources externes détaillées.
Moments clés
Repères établis par PSI à partir de la transcription : le créateur n'a pas défini de chapitres.
- Introduction au cours, présentation du sujet et des objectifs.
- Présentation de l'évolution des méthodes de traitement du langage : de la morphologie aux modèles de langue.
- Explication de l'hypothèse du sac de mots et de ses limites.
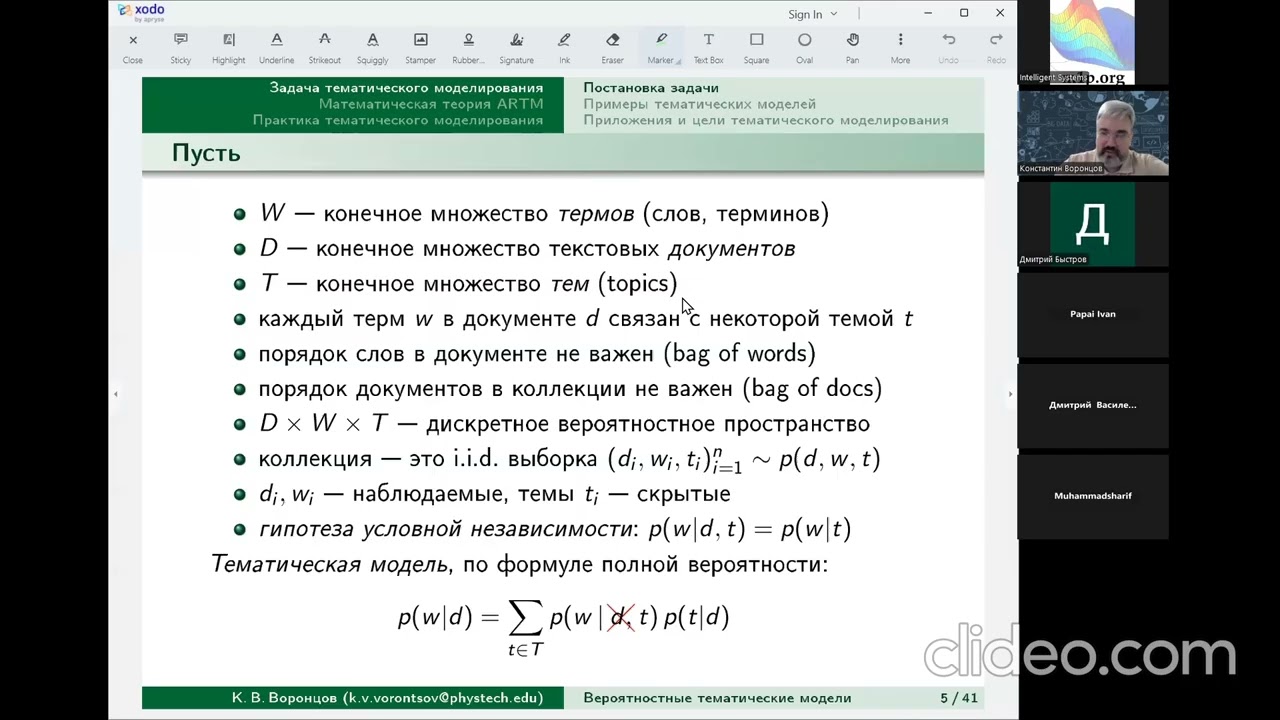
- Formulation mathématique du problème : maximisation de la vraisemblance, matrices phi et theta.
- Trois interprétations : clustering flou, factorisation matricielle, autoencodeur.
- Exemples d'application sur des articles Wikipédia bilingues.
- Discussion sur les modèles plus avancés intégrant les transformers et les LLM.
Sources citées
- word2vec (Mikolov et al., 2013) — Mentionné comme première représentation vectorielle des mots ne tenant pas compte du contexte.
- Latent Dirichlet Allocation (LDA) — Modèle bayésien de topic modeling classique cité comme approche probabiliste.
- Transformers (Vaswani et al., 2017) — Architecture devenue standard pour les modèles de langue, mentionnée comme rupture.
- BERT et GPT — Exemples de grands modèles de langue qui remplacent les approches classiques.
Apport & nouveautés
Le cours apporte une perspective originale sur les modèles thématiques probabilistes en les replaçant dans le contexte des modèles de langue modernes. Il propose de voir ces modèles comme des autoencodeurs, ce qui ouvre la voie à des extensions neuronales. L’accent sur la formulation en termes d’optimisation plutôt que bayésienne est également un choix didactique fort.
Pour aller plus loin :
- Latent Dirichlet allocation — L’article Wikipédia explique le modèle classique, utile pour approfondir.
- Word2vec — Pour comprendre les représentations vectorielles de mots et leurs limites.
- Transformer (architecure) — Pour explorer l’architecture qui a révolutionné le traitement du langage.
99 mots
Profil radar
Le profil radar montre une bonne maîtrise du sujet, avec une forte composante technique et une qualité d'information élevée. La quantité d'information est moyenne, car le cours est une introduction, mais le niveau de détail est appréciable.