mlsec journal club: Catastrophic Failure of LLM Unlearning via Quantization
mlsec journal club: Échec catastrophique du désapprentissage des LLM via la quantification
Mots-clés
Résumé
198 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
La valeur informative est significative : le sujet aborde une intersection peu étudiée entre désapprentissage et quantification, avec une hypothèse originale (faible taux d’apprentissage menant à des changements minuscules effacés par la quantification). L’argumentation s’appuie sur une lecture critique des résultats expérimentaux, en remettant en question certaines métriques et benchmarks. Cependant, les revendications reposent uniquement sur la discussion, sans preuves quantitatives supplémentaires ni comparaison avec d’autres travaux. La solidité de l’argumentation est donc moyenne, mais les raisonnements avancés sont cohérents et stimulent la réflexion sur la robustesse des méthodes de désapprentissage.
Rigueur scientifique, qualité des sources, adéquation du titre
La rigueur scientifique est limitée par l’absence de sources explicites : aucune référence bibliographique n’est citée dans la description, et la discussion se base sur un article non identifié clairement. Le titre du vidéo correspond fidèlement au contenu, ce qui est un point positif. L’analyse est cohérente, mais la méconnaissance de la méthodologie exacte de l’article (par exemple, la nature de la baseline idéale) soulève des doutes sur la profondeur de la revue. Globalement, la rigueur est correcte pour une discussion informelle, mais ne fournit pas d’éléments vérifiables.
194 mots
Adéquation titre / contenu
Le titre correspond exactement au contenu : l'échec du désapprentissage des LLM après quantification y est discuté en détail.
Qualité & fiabilité
6/10
L'analyse est technique et détaillée, mais repose sur une discussion informelle sans vérification indépendante des sources. Les hypothèses sont clairement exposées, mais la validité des benchmarks et des conclusions n'est pas toujours étayée.
Moments clés
Repères établis par PSI à partir de la transcription : le créateur n'a pas défini de chapitres.
- Introduction du problème : l'échec du désapprentissage après quantification des LLM.
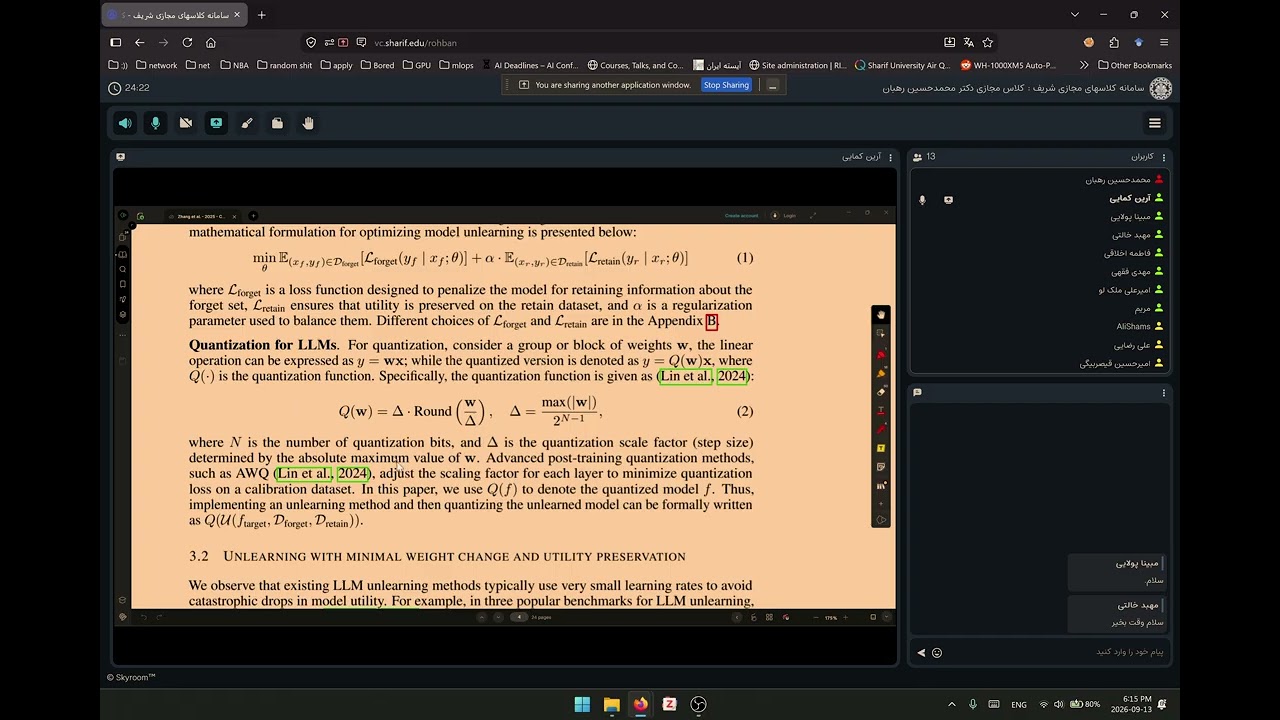
- Explication de l'hypothèse : les faibles taux d'apprentissage du désapprentissage sont annihilés par la quantification int4.
- Présentation des méthodes de désapprentissage (gradient ascent, NPO) et de la régularisation pour préserver le modèle.
- Analyse des résultats sur le benchmark MUSE : Harry Potter et jeux de données d'actualités, impact de la quantification.
- Discussion sur les solutions possibles, notamment l'utilisation de méthodes de quantification plus avancées (AWQ, GPTQ).
Apport & nouveautés
La contribution principale de cette session est d’attirer l’attention sur un phénomène peu documenté : la quantification peut neutraliser les effets du désapprentissage des LLM, avec une hypothèse explicative convaincante basée sur la sensibilité aux petits changements de poids. Cette discussion offre un éclairage critique sur la robustesse des méthodes actuelles et propose des pistes pour mieux évaluer ces interactions.
Pour aller plus loin :
- Machine unlearning — Vue d’ensemble du concept de désapprentissage en machine learning, pertinent pour comprendre le contexte.
- Quantization (signal processing) — Fondements mathématiques de la quantification, utiles pour saisir les mécanismes de perte d’information.
- Large language model — Contexte sur les modèles de langage visés par ces techniques.
113 mots
Profil radar
Le radar révèle un niveau technique élevé (8) et une quantité d'information correcte (7), mais une fiabilité globalement moyenne (5), ce qui est typique d'une discussion informelle entre experts sans contrôle des sources.