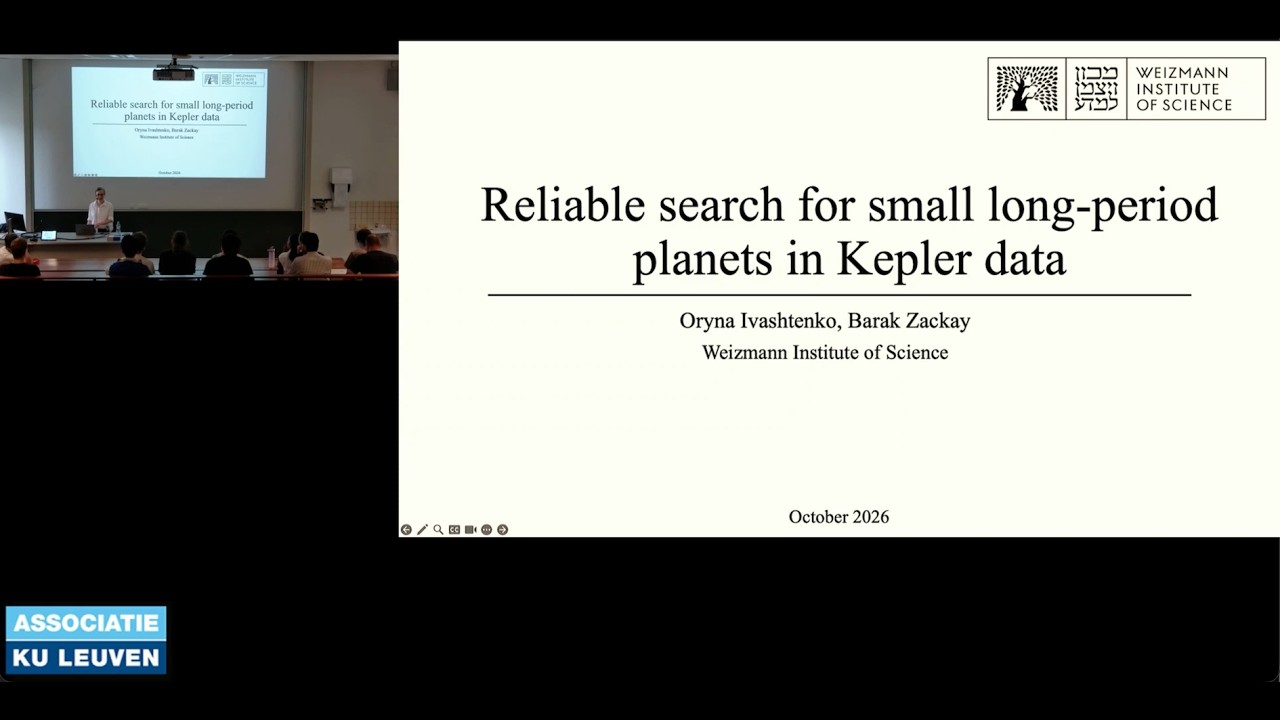
IvS Seminar: Oryna Ivashtenko(01/10/2026)
IvS Séminaire : Oryna Ivashtenko (01/10/2026)
Mots-clés
Résumé
201 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
La valeur des informations est élevée : la présentation ne se limite pas à une description superficielle, mais détaille les fondements statistiques, les choix méthodologiques et les compromis inhérents. L’argumentation est solide : chaque étape est justifiée par des considérations théoriques et validée par des expériences numériques, comme la comparaison avec les planètes confirmées et les tests de scrambling. La discussion sur la complétude et la fiabilité est particulièrement éclairante, et les limites (par exemple la perte de détection pour les longues périodes) sont clairement énoncées.
Rigueur scientifique, qualité des sources, adéquation du titre
La rigueur scientifique est manifeste : l’exposé s’appuie sur des modèles statistiques précis, une analyse des données réelles de Kepler et une validation par injection-récupération. Les sources sont principalement les publications Kepler et méthodologiques (mentionnées implicitement), mais aucune référence explicite n’est donnée dans la description vidéo. Le titre est adéquat, bien que générique ; il reflète le cadre du séminaire et le sujet exact. L’absence de commentaires ne permet pas d’analyser les réactions du public.
176 mots
Adéquation titre / contenu
Le titre reflète bien le contenu : un séminaire de l'IvS destiné à présenter une recherche fiable de petites planètes à longue période dans les données de Kepler.
Qualité & fiabilité
9/10
La présentation s'appuie sur une méthodologie statistique détaillée et rigoureuse, avec modélisation explicite du bruit, correction de non-gaussianité, tests d'injection-récupération et estimation de probabilités par planète. Les résultats sont cohérents avec les planètes confirmées de Kepler.
Moments clés
Repères établis par PSI à partir de la transcription : le créateur n'a pas défini de chapitres.
- Introduction de l'intervenante et de son groupe de recherche, axé sur les méthodes statistiques pour divers objets astrophysiques.
- Explication de la méthode de détection par transits et du problème de la contamination par le bruit non-gaussien.
- Présentation du modèle statistique du bruit et de la statistique de détection optimale (rapport de vraisemblance).
- Détail de la correction de non-gaussianité et de son effet sur la distribution des statistiques de détection.
- Méthode de calcul de la probabilité P_planet via injection-récupération et scrambling, avec résultats sur les planètes confirmées.
- Discussion sur la complétude et la fiabilité, et perspectives pour estimer les taux d'occurrence.
Apport & nouveautés
L’apport original réside dans la combinaison de méthodes statistiques avancées (souvent issues de l’analyse des ondes gravitationnelles) avec une correction spécifique de non-gaussianité, permettant de réduire considérablement le taux de faux positifs dans les données Kepler pour les petites planètes à longue période. Le pipeline fournit une probabilité par candidat, ce qui est plus informatif que les simples seuils de signal sur bruit. Cette approche est directement pertinente pour améliorer les estimations de taux d’occurrence dans un régime de paramètres encore peu contraint.
Pour aller plus loin :
- Kepler space telescope — Mission de référence pour la détection de planètes par transits.
- Transit method — Principe de détection utilisé.
- Exoplanet occurrence rates — Contexte scientifique de l’étude.
117 mots
Profil radar
Le profil radar est équilibré, avec des scores élevés en quantité et qualité d'information, ainsi qu'un niveau technique soutenu. La fiabilité légèrement inférieure reflète la complexité des données et les incertitudes inhérentes à la méthode, mais reste élevée.