CS 471/671 (How to grow language models) - #9 - Fall 2026
CS 471/671 (Comment faire grandir les modèles de langage) - #9 - Automne 2026
Mots-clés
Résumé
174 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
La valeur des informations est élevée : la tokenisation est un composant fondamental souvent implicite, et ce cours la démystifie avec des démonstrations concrètes. L’argumentation est solide, progressive, et les réponses aux questions montrent une maîtrise du sujet. L’exemple du tokenizer d’OpenAI est particulièrement parlant, car il permet de visualiser des phénomènes comme le traitement des espaces et des nombres, rarement expliqués. L’explication de BPE est bien structurée, passant de l’intuition à l’algorithme détaillé, puis à un exemple numérique. Les réponses aux questions sur la complexité et la parallélisation renforcent l’aspect pratique.
Rigueur scientifique, qualité des sources, adéquation du titre
La rigueur scientifique est bonne : le contenu est conforme aux pratiques industrielles et académiques. Les sources utilisées sont principalement le site du cours et le tokenizer d’OpenAI, mais aucune référence bibliographique explicite n’est citée. L’adéquation titre/contenu est parfaite : le cours s’inscrit dans une série sur la construction de modèles de langage, et la tokenisation en est une étape clé. Le titre traduit en français reflète bien le contenu.
177 mots
Adéquation titre / contenu
Le titre annonce un cours sur la croissance des modèles de langage ; le contenu sur la tokenisation est une étape centrale de ce processus, l'adéquation est donc totale.
Qualité & fiabilité
9/10
Contenu académique rigoureux, explication claire et didactique, exemples concrets et réponses aux questions.
Moments clés
Repères établis par PSI à partir de la transcription : le créateur n'a pas défini de chapitres.
- Introduction et rappel sur les représentations par mots, caractères et sous-mots
- Démonstration du tokenizer d'OpenAI sur un article du New York Times
- Analyse des espaces et des nombres dans la tokenisation
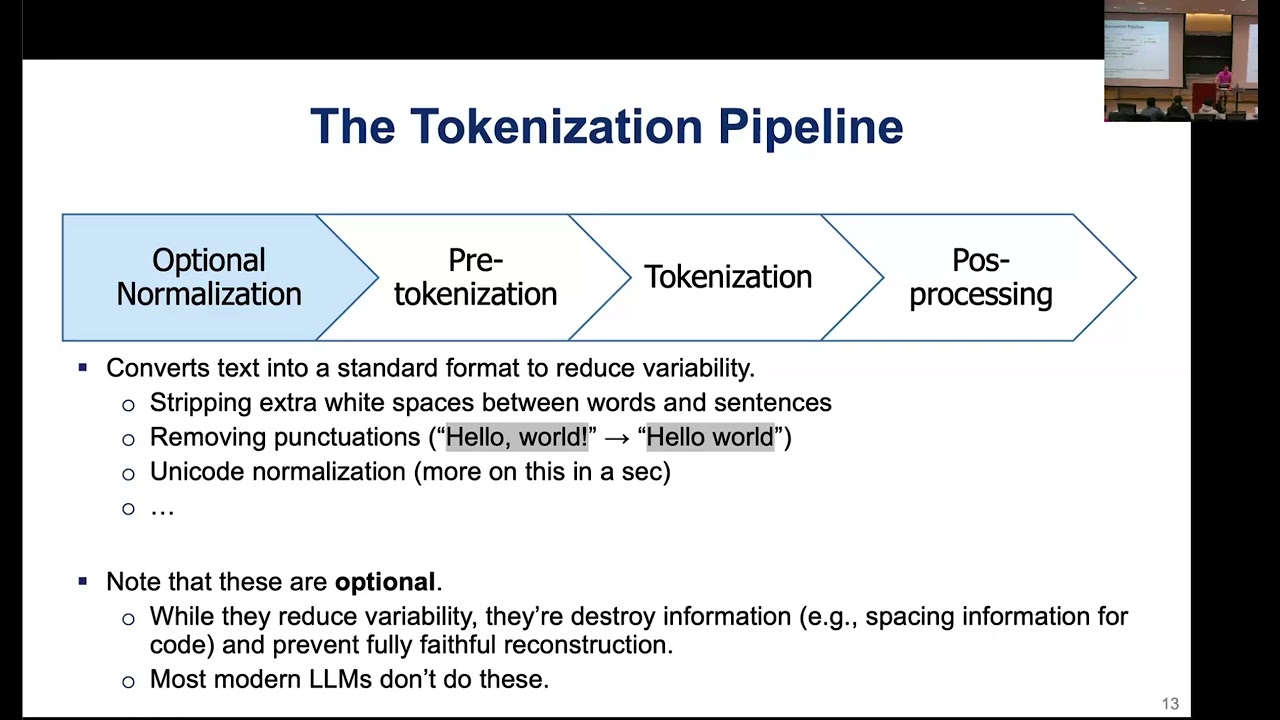
- Explication du pipeline : normalisation, prétokenisation, tokenisation, post-traitement
- Présentation de l'algorithme BPE et de son entraînement
- Exemple détaillé de BPE sur le corpus "DHU DHU DHU Hopkins hop hops"
Sources citées
- Cours CS 471/671 - site officiel — Décrit le contenu du cours et ses objectifs
Apport & nouveautés
Ce cours apporte une explication claire et pratique de la tokenisation, souvent reléguée à un détail technique. La démo interactive du tokenizer d’OpenAI permet de visualiser concrètement les choix de conception, comme l’encodage des espaces et des nombres. L’algorithme BPE est expliqué pas à pas, ce qui constitue une base solide pour comprendre les tokenizers modernes.
Pour aller plus loin :
- Byte pair encoding - Wikipedia — Algorithme original décrit dans le cours.
- SentencePiece - Wikipedia — Implémentation utilisée dans de nombreux modèles.
- Large language model - Wikipedia — Contexte global sur les modèles de langage.
96 mots
Profil radar
Le profil présente une forte qualité de fiabilité et une bonne quantité d'information, avec un niveau technique élevé, typique d'un cours académique sérieux.