CS 471/671 (How to grow language models) - #10 - Fall 2026
CS 471/671 (Comment faire grandir les modèles de langage) - #10 - Automne 2026
Mots-clés
Résumé
168 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
La valeur des informations est élevée : le cours offre une synthèse claire des méthodes de tokenisation et des architectures de modèles de langage, avec des exemples concrets et des intuitions utiles. L’argumentation s’appuie sur des travaux reconnus (Bengio, GPT, etc.), mais certaines affirmations restent peu sourcées et le professeur nuance lui-même des points controversés (comme la supériorité sémantique d’Unigram). La solidité de l’argumentation est correcte, mais on pourrait souhaité des références plus explicites.
Rigueur scientifique, qualité des sources, adéquation du titre
La rigueur scientifique est bonne : le contenu est factuel et conforme à l’état de l’art. Les sources mentionnées (Bengio 2003, OpenAI, Deepseek OCR) ne sont pas toutes citées avec des références précises, mais le cours renvoie à un site web. L’adéquation titre/contenu est partielle : le titre ‘How to grow language models’ est vague, le contenu se concentrant sur la construction progressive d’un modèle, la tokenisation étant un aspect clé. La description du cours précise les objectifs généraux.
168 mots
Adéquation titre / contenu
Le titre est générique et annonce un thème plus large que le contenu réel, qui se concentre sur la tokenisation et la construction d'un premier modèle de langage. Néanmoins, il reste cohérent avec le fil du cours.
Qualité & fiabilité
8/10
Exposé clair et structuré, fondé sur des travaux reconnus (Bengio, BPE, etc.), avec des nuances et limites signalées. Manque toutefois de citations explicites et de vérification des sources.
Moments clés
Repères établis par PSI à partir de la transcription : le créateur n'a pas défini de chapitres.
- Introduction et rappel de l'algorithme BPE et de ses variantes.
- Présentation de WordPiece et d'Unigram LM, approches descendantes vs ascendantes.
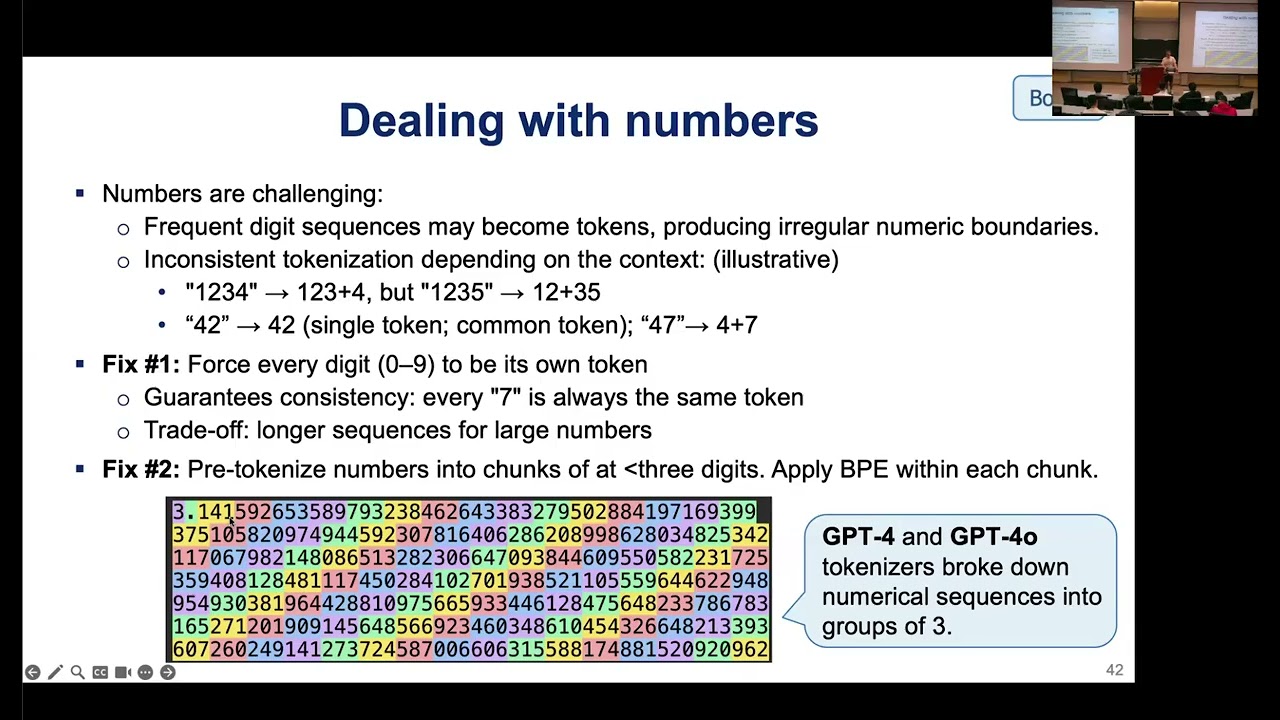
- Gestion des espaces et des nombres dans la tokenisation (GPT-2, GPT-4, Mixall).
- Explication des tokens réservés et de la taille du vocabulaire (30k-60k, puissances de deux).
- Passage à la construction d'un premier modèle de langage avec une matrice d'embedding.
- Exemple d'implémentation PyTorch de nn.Embedding et recherche d'indices.
- Présentation du modèle de Bengio (2003) et comparaison avec les n-grammes.
- Introduction de Super BP et de la représentation visuelle du texte (OCR).
Sources citées
- Course website: Self-Supervised CS JHU — Site du cours mentionné dans la description, contenant les ressources et le programme.
- A Neural Probabilistic Language Model (Bengio et al., 2003) — Article fondateur mentionné comme premier modèle de langage neuronal à l'aide d'un feedforward.
Sources concordantes
- Course website: Self-Supervised CS JHU — Le site officiel du cours corrobore les thèmes abordés et le contenu de la leçon.
Apport & nouveautés
L’apport de cette vidéo réside dans sa synthèse pédagogique des techniques de tokenisation et de modélisation de langage, intégrant des exemples concrets et des considérations pratiques (taille de vocabulaire, tokens réservés). Elle rappelle également des développements récents comme Super BP et la représentation visuelle du texte, montrant une veille active. La leçon ne présente pas de recherche originale mais offre une perspective utile pour comprendre les fondements des modèles de langage.
Pour aller plus loin :
- Byte pair encoding — Définition et historique de l’algorithme BPE.
- Word embedding — Concepts liés aux représentations vectorielles des mots.
- SentencePiece — Bibliothèque de tokenisation, référence pour Unigram LM et T5.
- A Neural Probabilistic Language Model — Page Wikipédia décrivant le modèle de Bengio (car l’URL de l’article original n’est pas certaine).
128 mots
Profil radar
Le profil radar est équilibré, avec des scores élevés en quantité et qualité d'information, ainsi qu'une fiabilité solide. Le niveau technique est légèrement inférieur, reflétant une orientation pédagogique plutôt que de recherche. La vidéo offre donc une base solide mais nécessite des approfondissements pour un public avancé.