Claude Sonnet 5: No Hype Full Breakdown & Testing
Claude Sonnet 5 : Analyse complète et tests sans langue de bois
Mots-clés
Résumé
155 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
La valeur principale réside dans la démonstration pratique, avec des exemples réels de builds et une comparaison directe des coûts et qualités. L’argumentation s’appuie sur des observations visuelles et des impressions subjectives, mais l’auteur reconnaît les limites de cette méthode (échantillon restreint, subjectivité). Il explique clairement son approche (blind grading, coûts trackés) et nuance ses propos en indiquant que les tests de codage sont plus décisifs que les tests d’écriture. La démonstration est convaincante pour donner un aperçu concret, mais manque de rigueur statistique.
Rigueur scientifique, qualité des sources, adéquation du titre
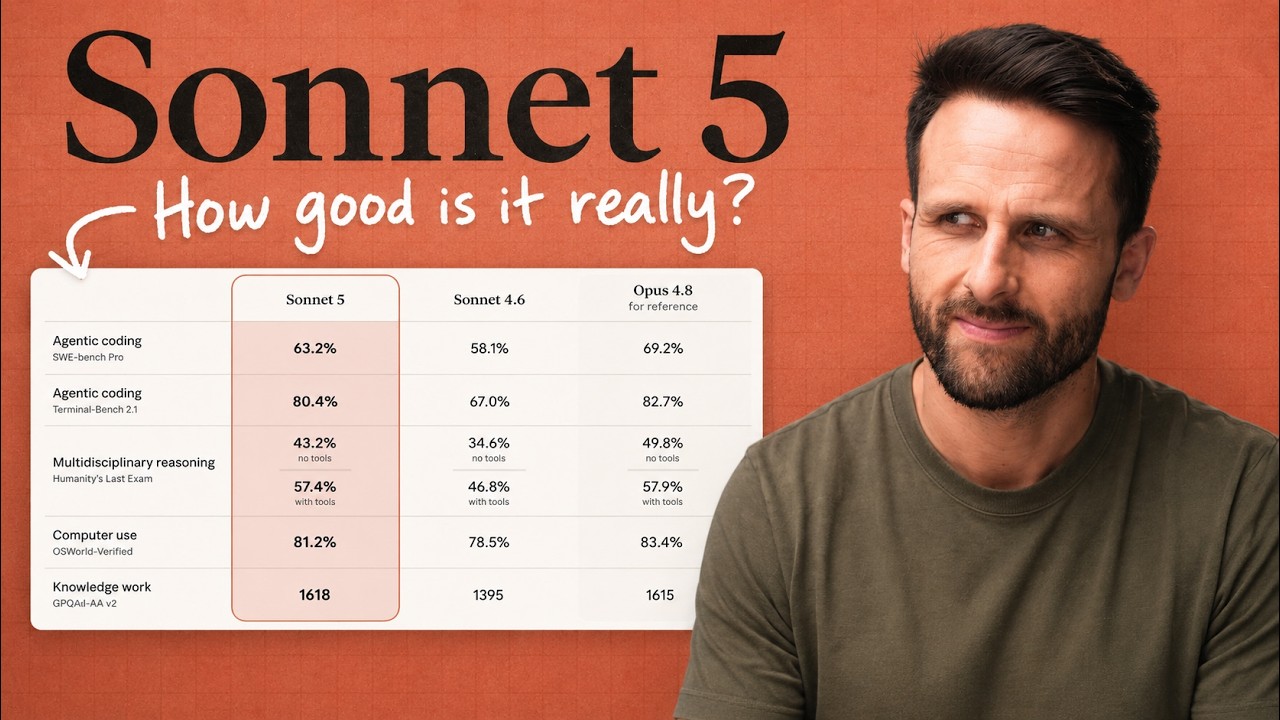
L’auteur cite des benchmarks d’Anthropic (Pro, Terminal Bench, Humanity’s Last Exam, computer use) sans fournir de liens directs, se contentant de les afficher à l’écran. Il utilise ses propres tests (SimmonsBench) et donne des accès à ses prompts sur simmonsbench.com. Les sources de la description sont principalement promotionnelles (bootcamp, newsletter). Le titre est fidèle au contenu : il décompose et teste sans exagération. La rigueur scientifique est limitée par l’absence de citation formelle, mais la démarche est transparente.
177 mots
Adéquation titre / contenu
Le titre annonce un test complet sans exagération, et la vidéo tient cette promesse en comparant trois modèles sur des tâches de codage et de travail intellectuel.
Qualité & fiabilité
7/10
La vidéo fournit une comparaison pratique de trois modèles sur des tâches variées, avec des coûts et des impressions subjectives. Elle s'appuie sur des benchmarks officiels (Anthropic) mais sans citer directement les sources, et la méthodologie est artisanale (évaluations visuelles, tests isolés). La fiabilité est donc moyenne, utile pour un premier aperçu.
Chapitres
- Intro
- Firing up SimmonsBench (15 builds, 3 models)
- The benchmarks: where Sonnet 5 lands
- Coding test 1: Designer portfolio site
- Coding test 2: Excalidraw clone
- Coding test 3: 3D nebula galaxy
- Coding test 4: Racing game
- Coding test 5: Low-poly terrain flyover
- Coding verdict: Opus takes it
- Knowledge work tests begin
- Knowledge test 1: Sales QBR deck
- Knowledge test 2: Finishing my essay
- Knowledge test 3: LinkedIn post
- Knowledge test 4: Writing a YouTube hook
- Final verdict + takeaways
Sources citées
- AI Bootcamp — Programme de formation mentionné en introduction et dans la description.
- Newsletter AI for Mortals — Inscription à la newsletter pour suivre le travail de l'auteur.
Apport & nouveautés
L’apport original est la mise en pratique comparative de trois modèles dans des scénarios réalistes, avec une évaluation subjective mais documentée. La méthodologie SimmonsBench, bien que maison, offre une perspective terrain utile. La vidéo ne présente pas de découverte technique, mais une évaluation pragmatique des performances et coûts.
Pour aller plus loin :
- Claude (language model) — Pour situer Claude Sonnet 5 dans la gamme Anthropic.
- Benchmark (informatique) — Pour comprendre les mesures de performance en informatique.
- “Humanity’s Last Exam” — Nouveau benchmark d’évaluation très difficile, mentionné dans la vidéo, sans URL confirmée ici.
94 mots
Profil radar
Le profil radar montre une quantité d'information élevée (8) mais une qualité (6) et une fiabilité (6) moyennes, avec un niveau technique correct (7). Cela correspond à une vidéo riche en exemples et démonstrations, mais dont la rigueur méthodologique reste perfectible.