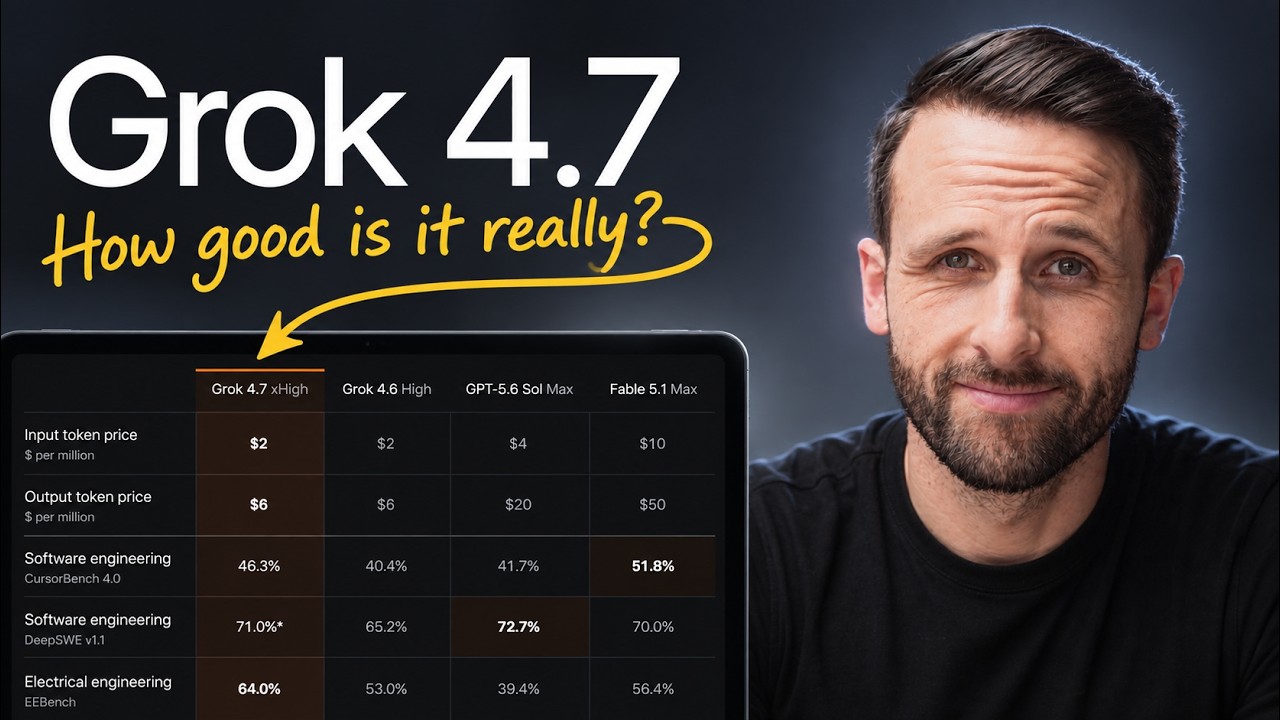
Grok 4.7: No-Hype Full Review & Testing
Grok 4.7 : Test complet et sans langue de bois
Mots-clés
Résumé
176 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
La valeur informative est notable : l’auteur propose un protocole de test bien défini avec des prompts spécifiques, des coûts détaillés et des comparaisons chiffrées. L’argumentation est structurée et honnête, reconnaissant les limites du test (one-shot) tout en soulignant l’écart de performance marqué pour les tâches créatives. La démonstration repose sur des éléments concrets (sites web, vidéos, coûts) et la conclusion est nuancée, distinguant les points forts de Grok 4.7 (coût, tâches quotidiennes) de ses faiblesses (génération créative, physique).
Rigueur scientifique, qualité des sources, adéquation du titre
La rigueur scientifique est correcte pour un test pratique : les sources citées sont la page du blog de l’auteur contenant les prompts et liens, ainsi que le site principal. L’absence de source externe pour les benchmarks est compensée par l’analyse critique de l’auteur. L’adéquation titre/contenu est excellente, ce qui renforce la crédibilité. Les commentaires ne sont pas fournis, donc aucune analyse des tendances du public n’est possible.
162 mots
Adéquation titre / contenu
Le titre reflète fidèlement le contenu : une revue complète sans enthousiasme excessif, avec tests approfondis.
Qualité & fiabilité
6/10
Test pratique limité à trois tâches de codage, méthodologie transparente (prompts, coûts, temps), mais échantillon restreint et absence de l'un des modèles dans certains benchmarks. Résultats cohérents avec la position économique annoncée.
Chapitres
- Intro
- Benchmarks and Pricing
- Where Grok 4.7 Looks Competitive
- Test 1: Cloning an Awwwards Website
- Website Clone Results and Model Reveal
- Website Clone Costs and Build Times
- Test 2: Interactive 3D Keyboard Product Page
- 3D Website Results, Costs and Model Reveal
- Test 3: Building Mario Kart’s Rainbow Road
- Mario Kart Results, Costs and Model Reveal
- Final Verdict
Sources citées
- AI for Mortals - Newsletter — La newsletter de l'auteur mentionnée dans la description.
- Blog : Grok 4.7 vs Fable 5.1 vs GPT-6 Astra — Lien vers l'article avec les prompts et ressources partagés.
Apport & nouveautés
Cette vidéo apporte une évaluation pratique et comparative de Grok 4.7, un modèle récemment publié, avec une focale sur les coûts et la qualité des sorties créatives. Elle comble le manque d’analyses indépendantes dans un contexte marketing intense. Le format de test reproductible (prompts accessibles) est un atout.
Pour aller plus loin :
- Grok (chatbot) sur Wikipédia — Pour comprendre l’évolution du modèle et son historique.
- Site officiel de xAI — Pour consulter les annonces officielles et les benchmarks de Grok 4.7.
- Awwwards — Site de référence pour les sites web primés, utilisé comme base du premier test.
98 mots
Profil radar
Le profil radar montre des scores moyens avec un niveau technique correct mais une fiabilité limitée par l'échantillon restreint. La quantité d'information est satisfaisante mais la qualité perçue est moyenne, reflétant le caractère subjectif des évaluations.