Lect 13 ML Risk Problem
Cours 13 Problème de risque de ML
Mots-clés
Résumé
234 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
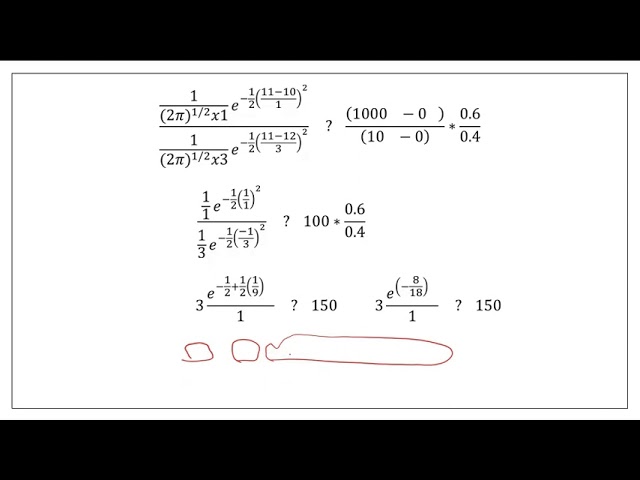
La valeur informative de cette vidéo réside dans l’illustration concrète et progressive d’un concept fondamental en théorie de la décision statistique : la minimisation du risque bayésien en présence de pertes asymétriques. L’enseignant part d’un problème appliqué (robot mobile devant distinguer route et boue) et déroule méthodiquement la démarche : définition des classes, des probabilités a priori, des vraisemblances (lois normales), des pertes, puis application de la règle de décision. L’argumentation est rigoureuse et suit une progression logique : rappel des notations (λij), écriture du rapport de vraisemblance, substitution des valeurs, calcul du seuil, comparaison et conclusion. L’enseignant insiste sur le fait que la décision ne vise pas seulement à minimiser la probabilité d’erreur mais à minimiser une perte attendue, ce qui est une nuance importante souvent mal comprise. L’exemple numérique est simple mais suffisamment riche pour montrer l’effet d’un déséquilibre important des coûts (1000 vs 10) sur le seuil de décision. La transition vers les fonctions discriminantes est naturelle et prépare le terrain pour des architectures de classification plus générales (sélecteur de maximum, extension à C classes). On peut regretter l’absence de démonstration complète du calcul du seuil et de la simplification de l’expression exponentielle, mais l’enseignant indique que les détails figurent dans les diapositives précédentes. La valeur pédagogique est réelle pour un public ayant déjà des bases en probabilités et en classification.
Rigueur scientifique, qualité des sources, adéquation du titre
La rigueur scientifique du contenu est bonne : les formules utilisées (densité normale, rapport de vraisemblance, seuil de risque) sont correctes et conformes aux manuels de référence. Aucune source externe n’est citée dans la vidéo ni dans la description, ce qui est courant pour un cours filmé. L’enseignant s’appuie sur des diapositives non visibles à l’écran, ce qui peut gêner le suivi, mais il énonce clairement les hypothèses et les valeurs numériques. L’adéquation titre/contenu est satisfaisante : « ML Risk Problem » annonce bien un problème de risque en apprentissage automatique, et le contenu traite effectivement de la minimisation du risque bayésien. Aucun commentaire n’étant fourni, aucune analyse des tendances du public n’est formulée.
353 mots
Adéquation titre / contenu
Le titre « ML Risk Problem » correspond bien au contenu : il s'agit d'un problème de décision bayésienne avec pertes asymétriques, illustré par un exemple concret (robot, route vs boue).
Qualité & fiabilité
7/10
Le contenu est un cours magistral de niveau universitaire sur la théorie de la décision bayésienne. Les concepts (fonction de perte, risque conditionnel, seuil de décision, fonctions discriminantes) sont exposés de manière standard et cohérente avec la littérature classique (Duda & Hart, Bishop). Aucune source externe n'est citée, mais la rigueur mathématique est présente. La vidéo est une captation de cours, ce qui limite la vérifiabilité mais pas la validité interne.
Moments clés
Repères établis par PSI à partir de la transcription : le créateur n'a pas défini de chapitres.
- Énoncé du problème : robot devant distinguer route et boue, avec probabilités a priori 0,4 et 0,6.
- Définition des pertes λ11=0, λ22=0, λ12=1000, λ21=10.
- Rappel de la règle de décision bayésienne : comparer le rapport de vraisemblance à un seuil.
- Substitution des valeurs dans la formule du seuil et calcul du seuil θ = 150.
- Calcul du rapport de vraisemblance pour x = 11 : résultat 1,92.
- Conclusion : 1,92 < 150, donc décision « boue » (ω2).
- Exercice proposé : que décider pour x = 9,5 ?
- Introduction des fonctions discriminantes g1(x), g2(x), ..., gc(x) et du sélecteur de maximum.
- Généralisation à C classes et annonce du prochain cours sur l'estimation des fonctions discriminantes.
Apport & nouveautés
Cette vidéo n’apporte pas de nouveauté scientifique ; elle constitue une séance de cours standard sur la théorie de la décision bayésienne appliquée à un problème de classification à deux classes avec pertes asymétriques. Son originalité réside dans l’illustration pédagogique (robot, route vs boue) et dans la transition vers les fonctions discriminantes. Elle s’adresse à des étudiants en apprentissage automatique et suppose une familiarité avec les probabilités et les lois normales.
Pour aller plus loin :
- Théorie de la décision bayésienne — Article Wikipédia présentant les fondements de la décision bayésienne et le risque associé.
- Fonction discriminante linéaire — Page sur l’analyse discriminante linéaire, qui formalise les fonctions discriminantes évoquées dans la vidéo.
- Classification naïve bayésienne — Article sur le classifieur bayésien naïf, qui utilise des hypothèses similaires de distributions conditionnelles.
- Richard O. Duda, Peter E. Hart, David G. Stork, « Pattern Classification » — Ouvrage de référence couvrant la théorie de la décision bayésienne et les fonctions discriminantes.
- Christopher M. Bishop, « Pattern Recognition and Machine Learning » — Manuel classique traitant du risque bayésien et des modèles de classification.
181 mots
Profil radar
Le profil radar montre une forte composante technique (niveau_technique 8) et une bonne qualité d'information (8), soutenues par une quantité d'information correcte (7). La fiabilité globale (7) est limitée par l'absence de sources externes et le format de captation de cours, mais le contenu reste cohérent et rigoureux.