Lect 11 ML Bayes Problem
Cours 11 Problème ML Bayes
Mots-clés
Résumé
268 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
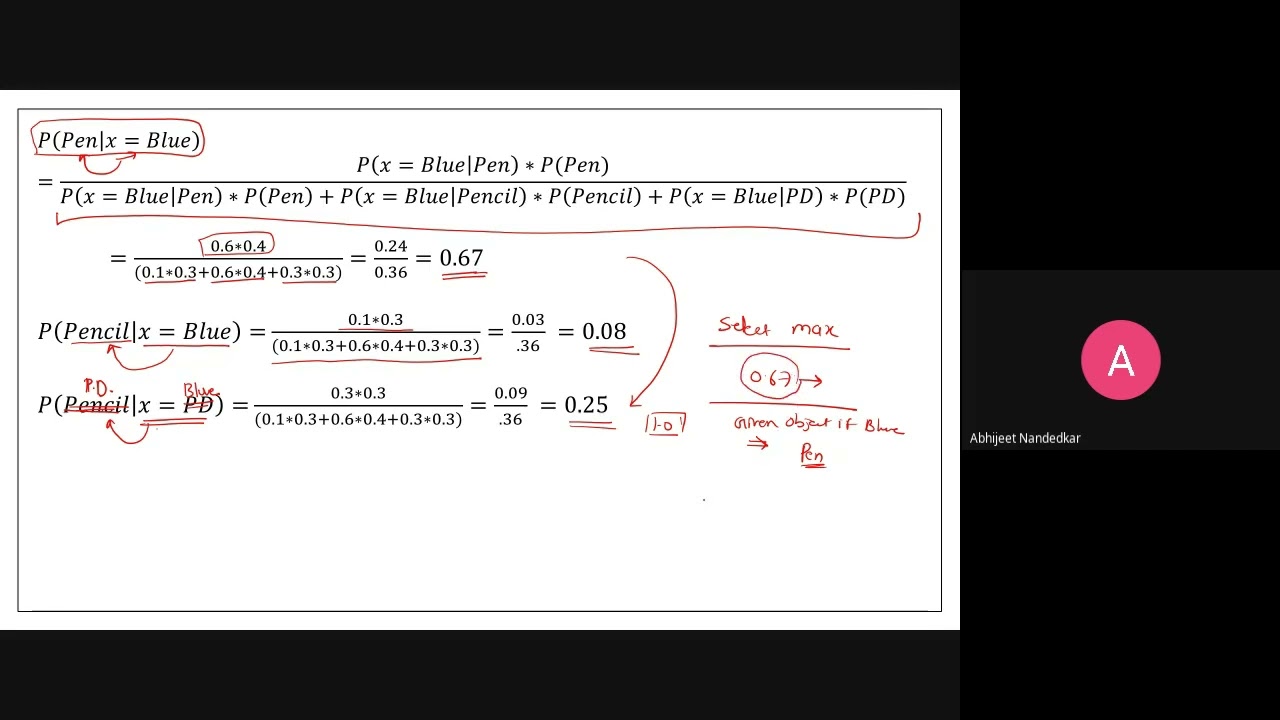
La valeur informative de cette leçon réside dans la progression pédagogique très claire : on part d’un problème discret à trois classes, on applique pas à pas le théorème de Bayes, on interprète chaque terme (vraisemblance, a priori, évidence, postérieure), puis on vérifie la cohérence des résultats (somme des postérieures égale à 1) et on conclut par une règle de décision explicite (maximum a posteriori) assortie du calcul de la probabilité d’erreur. Le second exemple, à deux classes et à variable continue discrétisée, renforce la compréhension en montrant le même mécanisme sur des mesures de diamètre. L’argumentation est rigoureuse et sans saut logique : chaque étape est justifiée, les formules sont posées avant d’être appliquées, et l’enseignant prend soin de distinguer les notions qui prêtent à confusion (vraisemblance conditionnelle à la classe vs probabilité de la classe). Le point le plus fort est la mise en évidence de la limite de l’approche par histogramme : l’absence d’une valeur dans l’échantillon rend la vraisemblance nulle et bloque toute décision. Cette observation motive naturellement le passage aux méthodes paramétriques, où l’on ajuste une loi normale pour interpoler et extrapoler. L’argumentation reste toutefois essentiellement procédurale : elle explique comment faire, mais discute peu les hypothèses sous-jacentes (indépendance, forme de la distribution, choix du modèle) ni les conséquences d’un mauvais ajustement. Le rythme est celui d’un cours en présentiel, avec quelques répétitions et hésitations, mais le fil conducteur reste solide et l’objectif d’apprentissage est atteint.
Rigueur scientifique, qualité des sources, adéquation du titre
La rigueur scientifique est bonne : les formules du théorème de Bayes, de la loi normale univariée et de sa généralisation multidimensionnelle sont correctement énoncées, et les calculs numériques sont exacts et vérifiables. La distinction entre produit scalaire et produit extérieur, ainsi que la définition de la matrice de covariance, sont présentées sans erreur. Aucune source bibliographique n’est citée, ni dans la description ni dans le discours : il s’agit d’un cours magistral s’appuyant sur des connaissances standard, ce qui n’est pas problématique en soi mais empêche toute traçabilité vers des travaux de référence. L’adéquation entre le titre et le contenu est parfaite : la vidéo traite bien de problèmes de Bayes en machine learning, dans le cadre annoncé d’une leçon numéro 11. Aucun commentaire n’étant fourni, aucune analyse des tendances du public n’est formulée.
391 mots
Adéquation titre / contenu
Le titre « Lect 11 ML Bayes Problem » correspond exactement au contenu : une leçon (lecture 11) consacrée à des problèmes de classification résolus par le théorème de Bayes en machine learning.
Qualité & fiabilité
7/10
Le contenu est un cours magistral de machine learning qui expose correctement le théorème de Bayes, la distinction prior/vraisemblance/évidence/postérieure, la règle de décision par maximum a posteriori et l'introduction des méthodes paramétriques (loi normale, moyenne, variance, covariance). Les calculs numériques présentés sont cohérents et vérifiables (0,67 + 0,08 + 0,25 = 1 ; 0,86 + 0,14 = 1). Aucune source externe n'est citée, mais il s'agit d'un enseignement standard dont les fondements sont bien établis. La qualité pédagogique est bonne, malgré quelques hésitations orales et une transcription imparfaite.
Moments clés
Repères établis par PSI à partir de la transcription : le créateur n'a pas défini de chapitres.
- Introduction du problème à trois classes (stylo, crayon, clé USB) et des trois couleurs possibles.
- Présentation de la table des vraisemblances conditionnelles et des probabilités a priori (0,4 ; 0,3 ; 0,3).
- Formulation de la question : quelle est la classe d'un objet observé bleu ?
- Application du théorème de Bayes et calcul de l'évidence par marginalisation sur les classes.
- Calcul des postérieures pour l'objet bleu : 0,67 (stylo), 0,08 (crayon), 0,25 (clé USB).
- Règle de décision par maximum a posteriori et calcul de la probabilité d'erreur (0,33).
- Second problème à deux classes : assiettes et seaux, mesures de diamètre.
- Application de Bayes au cas x = 0,1 : P(assiette | x) = 0,86 et P(seau | x) = 0,14.
- Limite de l'approche par histogramme : absence de la valeur 0,15 dans les données.
- Introduction des méthodes paramétriques et ajustement d'une loi normale (moyenne, variance).
- Formule de la densité normale univariée puis extension multidimensionnelle avec matrice de covariance.
- Distinction entre produit scalaire et produit extérieur, définition de la matrice de covariance.
Apport & nouveautés
Cette vidéo n’apporte pas de résultat de recherche original : il s’agit d’un cours magistral qui reprend des notions classiques de classification bayésienne et de méthodes paramétriques. Son apport est pédagogique : il montre de manière progressive comment passer d’un problème discret à trois classes à un problème continu à deux classes, comment interpréter chaque terme du théorème de Bayes, et pourquoi l’approche par histogramme échoue lorsque la valeur test n’est pas observée. L’introduction des méthodes paramétriques, avec la formule de la loi normale et sa généralisation multidimensionnelle, prépare la suite du cours. L’originalité réside dans la clarté de l’enchaînement et dans l’illustration numérique complète, plutôt que dans un contenu nouveau.
Pour aller plus loin :
- Théorème de Bayes — Fondement mathématique de toute la leçon.
- Classification naïve bayésienne — Application directe des concepts présentés.
- Loi normale — Modèle paramétrique utilisé pour l’ajustement des données.
- Matrice de covariance — Outil central de l’extension multidimensionnelle.
- Maximum a posteriori — Règle de décision employée dans les deux exemples.
166 mots
Profil radar
Le profil radar est équilibré et orienté vers la qualité et la fiabilité : les scores de quantité d'information, de qualité et de fiabilité globale sont élevés, tandis que le niveau technique reste modéré, cohérent avec un cours d'introduction. Ce profil correspond à un contenu pédagogique solide, sans prétention à l'exhaustivité ni à la recherche de pointe.