31 ml kmeans clustering
31 ML regroupement kmeans
Mots-clés
Résumé
161 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
La valeur informative de cette vidéo réside dans sa clarté pédagogique : elle expose pas à pas le fonctionnement de l’algorithme k-means, depuis l’initialisation aléatoire des centroïdes jusqu’à la convergence, en passant par le calcul des distances euclidiennes et la mise à jour des centres. L’argumentation est structurée et progressive, s’appuyant sur un exemple concret à quatre points qui permet de suivre les itérations et les changements d’affectation. L’auteur insiste sur des points essentiels : le caractère non supervisé, l’absence de labels, la contrainte sur k (entre 2 et le nombre d’échantillons), et l’importance de la convergence. Il introduit également la méthode du coude pour choisir k, en expliquant le compromis entre réduction de la distorsion et sur-segmentation. La démonstration reste toutefois limitée à un cas simple et ne discute pas des limites de l’algorithme (sensibilité à l’initialisation, formes de clusters, outliers). L’argumentation est donc solide pour une introduction, mais manque de profondeur critique.
Rigueur scientifique, qualité des sources, adéquation du titre
La rigueur scientifique est correcte sur le plan algorithmique : les étapes décrites sont conformes à la littérature classique sur k-means. Cependant, aucune source n’est citée, ni article fondateur (Lloyd, MacQueen), ni manuel de référence. L’auteur mentionne scikit-learn sans fournir de lien ou de documentation. L’adéquation titre/contenu est bonne : le titre annonce clairement un cours sur k-means, et le contenu y répond. Aucun commentaire n’étant fourni, aucune analyse des tendances du public n’est incluse.
244 mots
Adéquation titre / contenu
Le titre « 31 ml kmeans clustering » correspond bien au contenu : il s'agit d'un cours sur l'algorithme de clustering k-means, probablement le 31e d'une série. Adéquation correcte mais titre très générique.
Qualité & fiabilité
6/10
Le contenu présente correctement l'algorithme des k-moyennes (initialisation, affectation par distance euclidienne, recalcul des centroïdes, convergence) et la méthode du coude pour choisir k. Les explications sont exactes sur le fond mathématique. Cependant, aucune source externe n'est citée, la vidéo s'appuie uniquement sur une démonstration pédagogique et un exemple de code scikit-learn sans référence bibliographique. La qualité est bonne pour un cours introductif mais la traçabilité des sources est faible.
Moments clés
Repères établis par PSI à partir de la transcription : le créateur n'a pas défini de chapitres.
- Introduction : présentation du clustering non supervisé et de l'exemple de données sans labels.
- Définition de k et des contraintes : k entre 2 et le nombre d'échantillons, pas de clusters vides.
- Initialisation aléatoire des centroïdes et partition de l'espace par distance minimale.
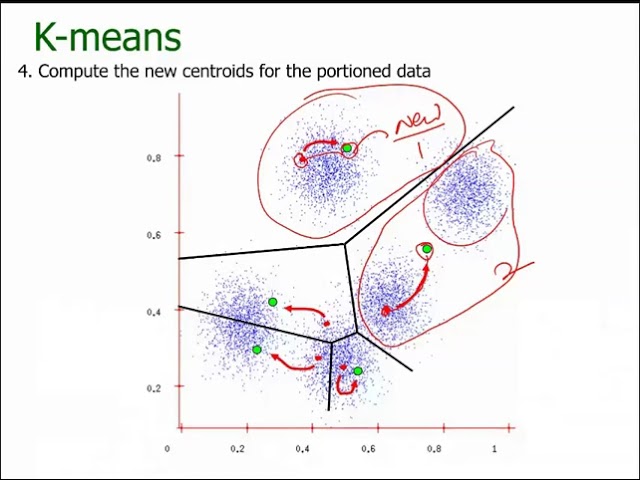
- Recalcul des centroïdes comme moyenne des points de chaque cluster et mise à jour des frontières.
- Répétition jusqu'à convergence : arrêt lorsque plus aucun point ne change de cluster.
- Exemple détaillé avec quatre points : matrice de partition, calcul des distances et réaffectation.
- Implémentation avec scikit-learn et intérêt de ne conserver que les k prototypes.
- Présentation de la méthode du coude pour choisir k en minimisant la somme des carrés des erreurs.
Apport & nouveautés
Cette vidéo n’apporte pas de nouveauté scientifique ; elle constitue une explication pédagogique classique de l’algorithme k-means et de la méthode du coude. Son intérêt réside dans la clarté de la présentation et l’illustration pas à pas, utile pour un public débutant.
Pour aller plus loin :
- K-means clustering — Article Wikipédia présentant l’algorithme, son historique et ses variantes.
- Elbow method (clustering) — Page détaillant la méthode du coude pour choisir le nombre de clusters.
- scikit-learn : KMeans — Documentation officielle de l’implémentation scikit-learn.
- Lloyd, S. P. (1982). Least squares quantization in PCM. IEEE Transactions on Information Theory — Article fondateur de l’algorithme k-means.
104 mots
Profil radar
Le profil radar montre une bonne quantité et qualité d'information pour un tutoriel introductif, avec un niveau technique modéré et une fiabilité globale correcte. La force réside dans la clarté pédagogique et l'exactitude algorithmique, tandis que la faiblesse principale est l'absence de sources citées et de discussion des limites.