33 ml HMM
33 millilitres HMM
Mots-clés
Résumé
232 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
La valeur informative de cette vidéo réside dans sa capacité à rendre accessible un sujet formellement dense : les HMM sont présentés à partir d’un exemple concret et progressif, ce qui permet de comprendre la logique des matrices de transition et d’émission avant d’aborder les problèmes algorithmiques. L’argumentation suit une progression pédagogique claire : définition du modèle, probabilité jointe, énoncé des trois problèmes, puis résolution détaillée du premier. Le raisonnement sur la complexité computationnelle est particulièrement instructif : l’orateur montre pourquoi l’approche naïve est impraticable et justifie ainsi naturellement l’introduction de l’algorithme forward. La démonstration de la récursion α est menée pas à pas sur un diagramme de transitions, avec des valeurs numériques explicites, ce qui constitue le cœur argumentatif de la vidéo. En revanche, l’argumentation reste orale et informelle : les notations sont approximatives, certaines affirmations sont énoncées sans démonstration complète (la dérivation de l’algorithme forward est explicitement éludée), et la distinction entre combinaisons et permutations d’états est floue. Le passage au décodage est bref et repose sur une heuristique de choix du α maximal qui n’est pas identifiée comme l’algorithme de Viterbi, ce qui constitue une lacune conceptuelle notable. La valeur globale est donc réelle pour un auditoire débutant, mais limitée pour un public cherchant une rigueur formelle ou une mise en perspective avec la littérature.
Rigueur scientifique, qualité des sources, adéquation du titre
La rigueur scientifique du contenu est globalement acceptable : les définitions et les équations présentées correspondent aux formulations standard des HMM, et l’exemple numérique est cohérent. Toutefois, aucune source n’est citée, aucun article fondateur (Baum-Welch, Viterbi, Rabiner) n’est mentionné, et aucune référence bibliographique n’est fournie dans la description, qui est vide. L’absence de sources rend impossible toute vérification externe et empêche de situer le cours dans une tradition académique. Sur le plan formel, plusieurs imprécisions subsistent : la confusion entre « permutations » et « combinaisons » d’états, l’usage oral de notations non standard, et l’absence de mention explicite de l’algorithme de Viterbi pour le décodage. Concernant l’adéquation titre/contenu, le titre « 33 ml HMM » est quasi inexploitable : il ne permet ni d’identifier le sujet précis ni de comprendre qu’il s’agit d’un cours sur les modèles de Markov cachés. Le contenu, lui, est bien conforme au thème annoncé par le sigle HMM, mais le titre ne remplit pas sa fonction informative.
396 mots
Adéquation titre / contenu
Le titre « 33 ml HMM » est très peu informatif et n'annonce pas clairement le contenu réel (introduction aux modèles de Markov cachés et à l'algorithme forward). L'adéquation est faible mais le contenu correspond bien au thème HMM.
Qualité & fiabilité
6/10
Le contenu est un cours magistral enregistré sur les modèles de Markov cachés (HMM). Les définitions, notations et algorithmes présentés (matrice d'émission, matrice de transition, état initial, problème d'évaluation, de décodage et d'apprentissage, algorithme forward, complexité O(N^T·T)) sont conformes à la littérature classique sur les HMM (Rabiner, Jurafsky & Martin). Aucune source n'est citée explicitement, aucune référence bibliographique n'est fournie, et la vidéo comporte des imprécisions de langage (confusion entre « permutations » et « combinaisons », notations orales approximatives). La qualité pédagogique est correcte mais la rigueur formelle reste limitée par l'absence de formalisation écrite et de références.
Moments clés
Repères établis par PSI à partir de la transcription : le créateur n'a pas défini de chapitres.
- Introduction de l'exemple météorologique : trois états cachés (ensoleillé, pluvieux, froid) et trois symboles observables (pull, parapluie, short).
- Présentation de la matrice d'émission et justification de son nom : probabilité d'émettre chaque symbole depuis chaque état.
- Calcul de la probabilité jointe entre une séquence d'états cachés et une séquence d'observations à partir des tables.
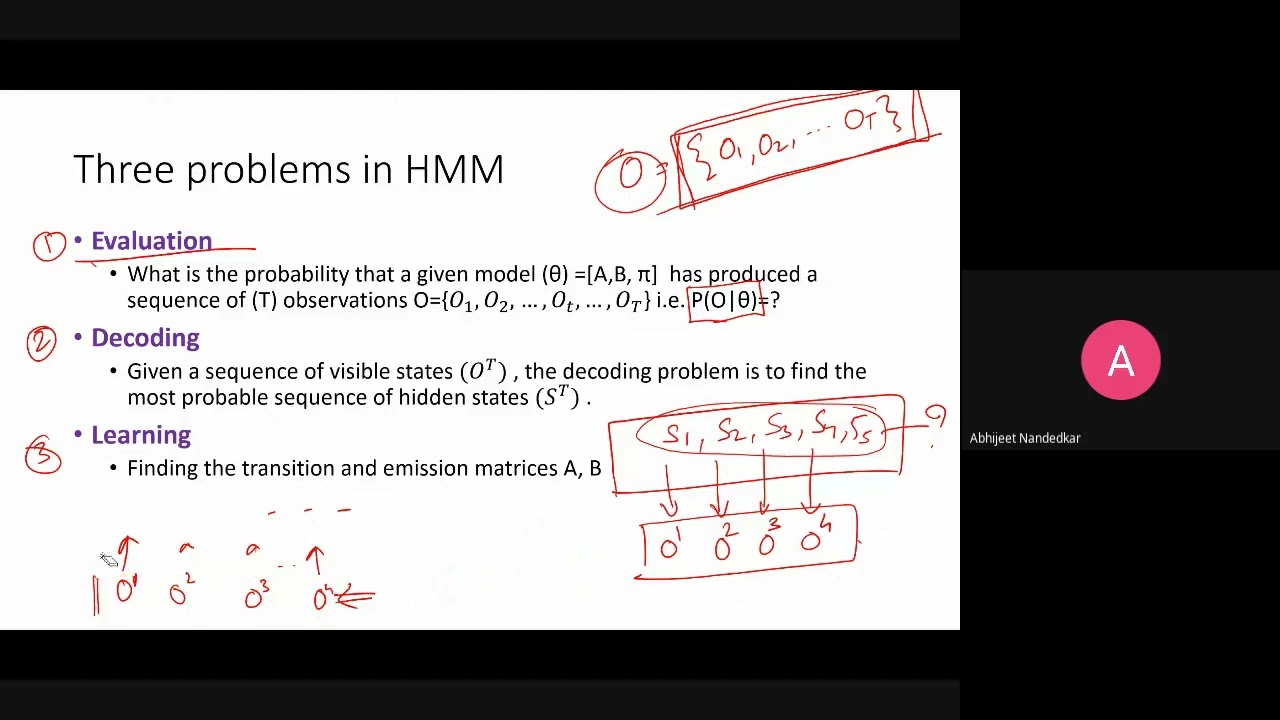
- Énoncé des trois problèmes des HMM : évaluation, décodage et apprentissage.
- Illustration du problème d'évaluation par l'analogie de la reconnaissance du locuteur.
- Formulation du problème d'évaluation : probabilité d'une séquence d'observations sachant le modèle Θ.
- Sommation sur toutes les séquences d'états cachés possibles et introduction de la complexité N^T.
- Calcul de la complexité : 10^21 opérations pour 10 états et une séquence de longueur 20.
- Introduction de l'algorithme forward et définition des variables α(t,i).
- Démonstration pas à pas du calcul récursif des α sur le diagramme de transitions.
- Réduction de complexité obtenue : passage de 10^21 à environ 10^3 opérations.
- Passage au problème de décodage : sélection du chemin de α maximal et notion d'état absorbant.
Apport & nouveautés
Cette vidéo n’apporte pas de contenu original au sens scientifique : il s’agit d’un cours d’introduction aux modèles de Markov cachés qui reprend des notions classiques et bien établies. Son apport réside dans la clarté de l’exemple météorologique et dans la démonstration progressive de l’algorithme forward, qui permet de comprendre intuitivement pourquoi la récursion réduit drastiquement la complexité computationnelle. La présentation du problème d’évaluation comme point de départ, avant le décodage et l’apprentissage, constitue une progression pédagogique cohérente. En revanche, la vidéo ne propose aucune innovation, aucune comparaison avec des approches modernes (réseaux de neurones récurrents, transformers) et ne cite aucune source académique.
Pour aller plus loin :
- Hidden Markov model — Article encyclopédique de référence présentant les HMM, leurs trois problèmes et les algorithmes associés.
- Forward algorithm — Détail de l’algorithme forward et de la récursion sur les variables α.
- Viterbi algorithm — Algorithme de programmation dynamique pour le décodage, non nommé explicitement dans la vidéo mais correspondant au problème traité.
- Baum-Welch algorithm — Algorithme d’apprentissage des paramètres d’un HMM, correspondant au troisième problème évoqué.
- Lawrence R. Rabiner, « A Tutorial on Hidden Markov Models and Selected Applications in Speech Recognition », Proceedings of the IEEE, 1989 — Article fondateur de référence sur les HMM, non cité dans la vidéo.
211 mots
Profil radar
Le profil radar montre un contenu à dominante technique modérée : la quantité d'information et la qualité sont correctes sans être exceptionnelles, le niveau technique est relativement élevé pour une introduction, et la fiabilité globale reste moyenne en raison de l'absence de sources et d'imprécisions formelles. Le profil est celui d'un cours pédagogique utile mais non référencé.