27 ml DT 03
Mots-clés
Résumé
194 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
Le contenu présente une valeur pédagogique réelle : il expose de façon structurée les questions de conception d’un arbre de décision et les critères de sélection de features. L’argumentation repose sur une progression logique claire, partant du problème général (comment diviser un ensemble de données) vers des mesures formelles d’impureté. L’exemple géométrique à deux features est particulièrement efficace pour faire comprendre intuitivement pourquoi certains features sont plus discriminants que d’autres. Le calcul détaillé de l’entropie sur le jeu de données « contact lenses » (24 instances, trois classes) ancre la théorie dans un cas concret et vérifiable. En revanche, l’argumentation reste descriptive et ne discute pas les limites des méthodes présentées, ni les cas où l’entropie et Gini divergent en pratique. Aucune comparaison empirique de performance entre ID3, C4.5 et CART n’est fournie. La valeur réside donc dans la clarté de l’exposition des fondements, non dans un apport analytique ou critique.
Rigueur scientifique, qualité des sources, adéquation du titre
La rigueur scientifique est globalement bonne : les formules d’entropie, d’impureté de Gini et d’erreur de classification sont correctement énoncées, et l’attribution de chaque mesure à son algorithme (entropie → ID3, Gini → CART) est exacte. La mention de Shannon et du passage de l’entropie de la physique à la théorie de l’information est pertinente, bien qu’aucune référence bibliographique précise ne soit donnée. Aucune source n’est citée dans la description ni dans le corps de la vidéo, ce qui empêche toute vérification externe et constitue une faiblesse notable pour un contenu académique. L’adéquation titre/contenu est faible : le titre « 27 ml DT 03 » est un simple identifiant de cours qui n’informe pas sur le sujet traité, mais il n’induit pas en erreur. Aucun commentaire n’étant fourni, aucune analyse des tendances du public n’est formulée.
302 mots
Adéquation titre / contenu
Le titre « 27 ml DT 03 » est un identifiant de cours (machine learning, Decision Tree, séance 3) ; il est purement technique et n'annonce pas explicitement le contenu, mais reste cohérent avec la vidéo.
Qualité & fiabilité
7/10
Cours magistral de machine learning portant sur la construction d'arbres de décision (ID3, C4.5, CART). Le contenu est exact et cohérent avec la littérature classique (Quinlan, Breiman). Aucune source n'est citée ni liée en description, ce qui empêche toute vérification externe. La rigueur pédagogique est bonne mais l'absence de références formelles et de données empiriques limite le score.
Moments clés
Repères établis par PSI à partir de la transcription : le créateur n'a pas défini de chapitres.
- Introduction musicale et rappel de la structure d'un arbre de décision (nœud racine, nœuds enfants, feuilles).
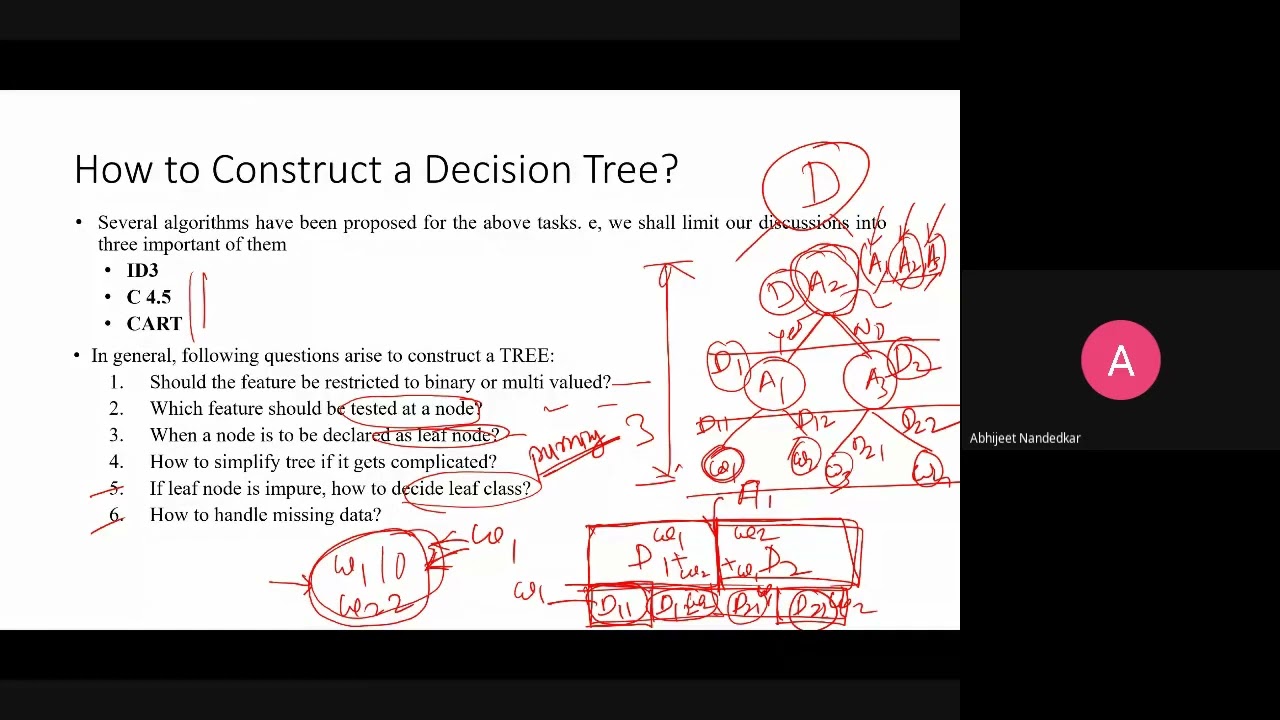
- Présentation des algorithmes ID3, C4.5 et CART et des questions fondamentales de construction d'un arbre.
- Problème du choix du feature à tester en premier : quel attribut minimise la profondeur de l'arbre.
- Discussion sur la déclaration d'un nœud comme feuille et la gestion des nœuds impurs par vote majoritaire.
- Mention de l'élagage (pruning) et du problème du sur-apprentissage (overfitting).
- Exemple géométrique à deux features (X et Y) montrant qu'un bon feature sépare immédiatement les classes.
- Cas d'un jeu de données non séparable par une ligne parallèle aux axes et construction de l'arbre correspondant.
- Introduction des mesures d'impureté : entropie (ID3), impureté de Gini (CART) et erreur de classification.
- Origine de l'entropie en physique puis en théorie de l'information (Shannon) et comportement de la courbe d'entropie.
- Exemple du jeu de données « contact lenses » (24 instances, 3 classes) et calcul de l'entropie initiale (1,3261).
Apport & nouveautés
Cette vidéo ne présente pas de contenu original au sens de la recherche : il s’agit d’un cours de niveau master/ingénieur exposant des notions classiques de machine learning (arbres de décision, entropie, impureté de Gini). Son apport réside dans la clarté de la progression pédagogique et dans l’illustration géométrique du choix de feature. Elle ne propose ni résultat nouveau, ni analyse comparative, ni perspective critique sur les méthodes présentées.
Pour aller plus loin :
- Decision tree learning — Article de synthèse sur les arbres de décision, leurs algorithmes et leurs applications.
- Entropy (information theory) — Définition formelle de l’entropie de Shannon, base du critère ID3.
- C4.5 algorithm — Algorithme de Quinlan, successeur d’ID3, utilisant le gain d’information normalisé.
- Gini impurity — Mesure d’impureté utilisée par CART, comparée à l’entropie.
- Overfitting — Concept d’ajustement excessif aux données d’entraînement, mentionné dans la vidéo à propos de l’élagage.
145 mots
Profil radar
Le profil radar indique un contenu à dominante pédagogique et théorique : quantité et qualité d'information correctes, niveau technique modéré, fiabilité globale bonne. Le point faible est l'absence de sources citées et de validation empirique, ce qui abaisse la note globale malgré la solidité des fondements exposés.