04 ML regression 03
04 ML régression 03
Mots-clés
Résumé
256 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
La valeur pédagogique de cette séance réside dans la progression rigoureuse du raisonnement : on part de l’intuition géométrique (minimiser l’aire des carrés des écarts) pour aboutir à une formule fermée exploitable en pratique. L’enseignant ne se contente pas d’énoncer beta1 = cov(X,Y)/var(X) : il construit cette expression pas à pas, en montrant explicitement l’astuce algébrique qui consiste à soustraire et ajouter la moyenne de X dans les sommes, ce qui permet de faire apparaître les termes de covariance et de variance. Cette démarche est particulièrement formatrice car elle relie la formule statistique à sa dérivation analytique. L’argumentation est également solide dans le passage du cas univarié au cas multivarié : l’introduction de la colonne de 1 dans la matrice de design est justifiée par la volonté d’écrire l’estimation sous forme matricielle compacte, ce qui prépare naturellement la généralisation à la régression multiple et aux méthodes d’optimisation itératives. L’exemple numérique à cinq points, avec vérification manuelle des prédictions (x=1 donne y_chapeau=1,2 au lieu de 1, etc.), ancre concrètement la théorie. On peut toutefois regretter que l’argumentation reste purement mathématique : aucune discussion sur les hypothèses statistiques sous-jacentes (linéarité, homoscédasticité, indépendance des erreurs, normalité des résidus), sur les limites de l’OLS en présence de valeurs aberrantes ou de multicolinéarité, ni sur les alternatives (régularisation, régression robuste). Le lien avec l’apprentissage automatique moderne reste implicite : on ne mentionne pas que l’OLS est un cas particulier de minimisation d’une fonction de coût par descente de gradient, ce qui aurait permis de faire le pont avec les réseaux de neurones.
Rigueur scientifique, qualité des sources, adéquation du titre
La rigueur mathématique est irréprochable : chaque étape de la dérivation est justifiée, les notations sont cohérentes (passage de beta à theta pour le cas multivarié), et les résultats sont vérifiés numériquement. Le code Python présenté est minimal mais correct : les fonctions mean, covariance et variance implémentent fidèlement les formules dérivées, et l’enseignant insiste pour que les étudiants écrivent eux-mêmes la partie tracé de la droite. En revanche, la qualité des sources est nulle au sens académique : aucune référence bibliographique n’est citée, ni manuel, ni article fondateur (Legendre, Gauss, Galton, Pearson), ni documentation de bibliothèque (scikit-learn, numpy). Le contenu est présenté comme un savoir établi, sans contextualisation historique ni comparaison avec d’autres approches. L’adéquation titre/contenu est correcte : le titre numéroté correspond bien à une séance de cours sur la régression, mais il n’informe pas sur le contenu précis (dérivation OLS, covariance/variance, extension multivariée). Aucun commentaire n’étant fourni, aucune analyse des tendances du public n’est formulée.
430 mots
Qualité & fiabilité
7/10
Le contenu mathématique présenté est exact et classique : dérivation complète de la régression par moindres carrés ordinaires (OLS), passage à la forme matricielle, expression de beta1 comme rapport covariance/variance, puis extension au cas multivarié avec les thetas et la matrice de design augmentée d'une colonne de 1. Aucune erreur de fond détectée. La fiabilité est toutefois limitée par l'absence totale de références bibliographiques, de sources externes et de contextualisation historique ou comparative. Il s'agit d'un cours magistral filmé, non d'une publication scientifique, ce qui plafonne naturellement le score.
Moments clés
Repères établis par PSI à partir de la transcription : le créateur n'a pas défini de chapitres.
- Rappel du principe de la régression : ajuster f telle que y_chapeau soit proche de y, mesure par RMSE.
- Distinction entre régression univariée (droite) et multivariée (plan ou hyperplan).
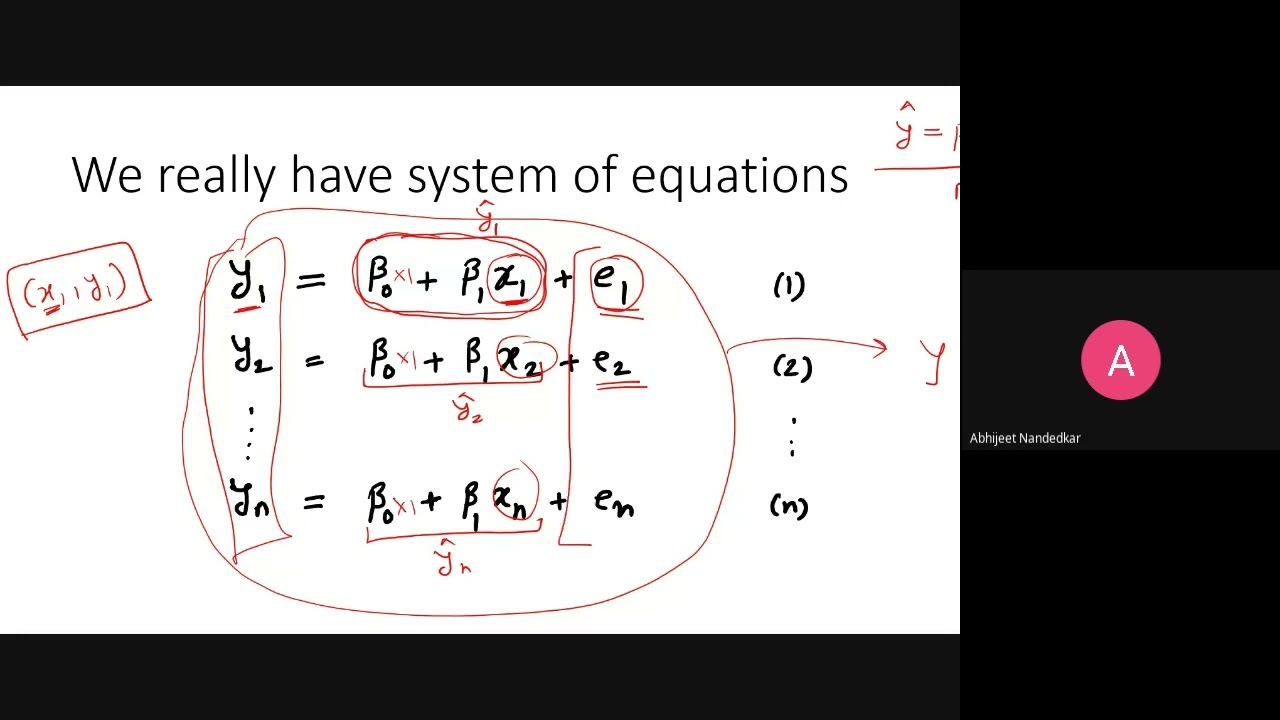
- Écriture du modèle y_i = beta0 + beta1·x_i + erreur et objectif de minimisation de l'erreur quadratique.
- Passage à la forme matricielle : erreur = Y - A·beta, minimisation de la norme au carré.
- Différentiation par rapport à beta0 puis beta1, annulation des dérivées, obtention du système d'équations.
- Astuce algébrique : ajout d'un terme nul (somme des écarts à la moyenne) pour simplifier l'expression de beta1.
- Identification de beta1 = covariance(X,Y) / variance(X) et beta0 = moyenne(Y) - beta1·moyenne(X).
- Exemple numérique à cinq échantillons : (1,1), (2,3), (4,3), (3,2), (5,5).
- Implémentation Python des fonctions mean, covariance et variance, puis calcul de beta0 et beta1.
- Vérification manuelle des prédictions : x=1 donne y_chapeau=1,2, x=2 donne 2, etc.
- Extension au cas multidimensionnel : passage des beta aux thetas, introduction de x_i0 = 1.
- Écriture matricielle Y_chapeau = X·Theta, où X est la matrice de design augmentée d'une colonne de 1.
- Fin de la partie théorique et transition vers une discussion administrative sur le syllabus de DSP.
Apport & nouveautés
Cette séance n’apporte pas de contenu original au sens de la recherche : elle constitue une reprise pédagogique standard de la dérivation des moindres carrés ordinaires, matière enseignée depuis le début du XIXe siècle. Son intérêt réside dans la clarté de l’enchaînement entre la forme scalaire, la forme matricielle et l’implémentation Python, ainsi que dans l’astuce algébrique explicite qui fait apparaître la covariance et la variance. L’extension au cas multivarié avec la matrice de design augmentée prépare naturellement la régression multiple et les méthodes d’optimisation itératives utilisées en apprentissage automatique. En revanche, aucun lien n’est fait avec les approches modernes (descente de gradient, régularisation, régression ridge ou lasso), ce qui limite la portée du contenu pour un public déjà familier avec le machine learning.
Pour aller plus loin :
- Régression linéaire — Article de synthèse couvrant les fondements, les hypothèses et les extensions de la régression linéaire.
- Moindres carrés ordinaires — Présentation de la méthode des moindres carrés, de son histoire et de ses propriétés statistiques.
- Covariance et variance — Définitions formelles et interprétations des notions utilisées dans la formule de beta1.
- Régression ridge — Extension régularisée de l’OLS, utile en présence de multicolinéarité ou de nombreuses variables.
- Théorème de Gauss-Markov — Justification théorique de l’optimalité de l’estimateur OLS sous les hypothèses classiques.
213 mots
Profil radar
Le profil radar est celui d'un cours magistral technique : quantité d'information et niveau technique élevés, qualité et fiabilité solides sur le plan mathématique, mais absence totale de sources externes et de contextualisation. Le contenu est dense et rigoureux, mais reste confiné à une exposition théorique sans mise en perspective avec la littérature ou les pratiques modernes.