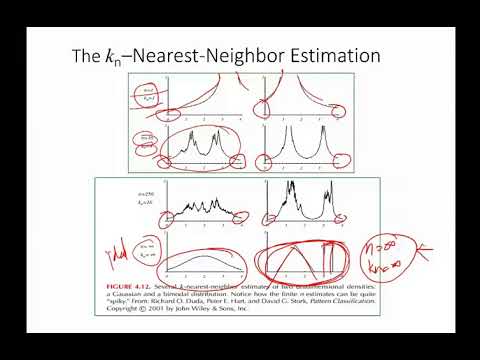
23 ml KNN estimate
Estimation KNN de 23 ml
Mots-clés
Résumé
284 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
La valeur informative de cette séance réside dans la clarté de l’opposition structurelle entre deux schémas d’estimation non paramétrique : Parzen fixe le volume et laisse varier le nombre de voisins, KNN fixe le nombre de voisins et laisse varier le volume. Cette mise en regard est pédagogiquement efficace et permet de comprendre pourquoi KNN s’adapte localement à la densité des données : là où les échantillons sont denses, une petite fenêtre suffit et l’estimation est précise ; là où ils sont rares, la fenêtre doit s’élargir et l’estimation se dégrade. L’argumentation progresse par exemples numériques entièrement traités à la main, ce qui rend la procédure reproductible pas à pas : choix de h initial, calcul des bornes x ± h/2, comptage, élargissement itératif, calcul final de la densité. Le passage de l’estimation de vraisemblance à la classification bayésienne est également bien articulé, avec la précaution méthodologique importante de ne jamais mélanger les échantillons des deux classes lors de l’estimation des vraisemblances conditionnelles. La démonstration que la règle KNN estime directement la probabilité a posteriori est le point le plus fort du cours : en posant p(x, ω_i) = k_i/(nV) et p(x) = k/(nV), la simplification donne p(ω_i|x) = k_i/k, ce qui justifie rigoureusement le vote majoritaire comme estimateur de la posterior. L’argumentation reste toutefois essentiellement procédurale : elle expose le « comment » avec soin mais discute peu le « pourquoi » théorique (conditions de convergence, comportement asymptotique, lien avec la dimensionnalité). Le défaut d’intégrabilité de l’estimateur KNN est signalé honnêtement, mais sans développement sur ses conséquences pratiques ni sur les remèdes possibles.
Rigueur scientifique, qualité des sources, adéquation du titre
La rigueur mathématique interne est bonne : les formules sont posées correctement, les calculs numériques des exemples sont cohérents, et la distinction terminologique entre estimation KNN et règle KNN est explicitement martelée pour éviter les confusions. Le cours signale spontanément une limite théorique réelle de la méthode (non-intégrabilité de la densité estimée à 1), ce qui témoigne d’une honnêteté intellectuelle appréciable. En revanche, aucune source, référence bibliographique ou attribution n’est fournie : ni les travaux fondateurs sur l’estimation par noyaux, ni les articles classiques sur la règle des k plus proches voisins ne sont cités, et la description de la vidéo est vide, ce qui prive l’auditeur de tout point d’entrée documentaire. L’adéquation titre/contenu est correcte : le titre, bien que très bref et peu explicite, correspond exactement au sujet traité. Aucun commentaire n’étant fourni, aucune analyse des tendances du public n’est formulée.
422 mots
Qualité & fiabilité
7/10
Cours magistral universitaire sur l'estimation non paramétrique de densité. Le contenu est mathématiquement correct : formule de Parzen (k/(nV)), inversion du principe en KNN (fixer k, ajuster V), démonstration que la règle KNN approxime directement la probabilité a posteriori (k_i/k), et mention explicite du défaut d'intégrabilité de l'estimateur KNN (l'intégrale de la densité estimée ne converge pas vers 1). Aucune source externe citée, mais la matière est standard et exacte. La qualité est limitée par l'absence de références bibliographiques et par un exposé oral parfois redondant.
Moments clés
Repères établis par PSI à partir de la transcription : le créateur n'a pas défini de chapitres.
- Rappel de la fenêtre de Parzen et introduction de l'estimation KNN comme méthode à fenêtre croissante.
- Distinction terminologique entre estimation KNN et règle KNN, deux objets différents malgré des noms similaires.
- Principe de l'estimation KNN : fixer k (souvent √n) et faire croître le volume jusqu'à capturer k voisins.
- Effet du nombre de voisins k sur le lissage de la densité estimée : k plus grand donne une estimation plus régulière.
- Adaptation locale : petite fenêtre dans les zones denses, grande fenêtre dans les zones peu denses.
- Cas limite n = 1, k = 1 : démonstration que la densité estimée ne tend pas vers zéro et que son intégrale diverge.
- Exemple numérique complet d'estimation : x_test = 3,1, h initial = 0,5, élargissement jusqu'à k = 6, p(x) = 0,3.
- Exemple de classification en deux classes : estimation séparée de p(x|ω1) et p(x|ω2) puis application de la règle de Bayes.
- Introduction de la règle KNN : estimation directe de la probabilité a posteriori par vote majoritaire parmi les k voisins.
- Démonstration que p(ω_i|x) = k_i/k par simplification des termes n et V, justifiant le vote majoritaire.
Apport & nouveautés
Cette séance n’apporte pas de résultat original : elle constitue une exposition pédagogique structurée de méthodes classiques d’estimation non paramétrique et de classification. Son intérêt propre est didactique : l’opposition systématique entre fenêtre de Parzen (volume fixe, k variable) et estimation KNN (k fixe, volume variable) offre une grille de lecture claire, et la dérivation p(ω_i|x) = k_i/k est présentée de manière suffisamment détaillée pour être reproduite. La mise en garde sur le défaut d’intégrabilité de l’estimateur KNN, souvent passée sous silence dans les présentations introductives, est un point de rigueur appréciable. En revanche, le cours ne traite ni le choix optimal de k, ni la malédiction de la dimensionnalité, ni les variantes pondérées par la distance, qui sont pourtant les prolongements naturels et indispensables de la méthode.
Pour aller plus loin :
- k-nearest neighbors algorithm — Article encyclopédique couvrant la règle de classification, le choix de k et les variantes pondérées.
- Kernel density estimation — Présentation de l’estimation par noyaux, dont la fenêtre de Parzen est un cas particulier.
- Curse of dimensionality — Phénomène expliquant la dégradation des méthodes de voisinage en grande dimension, non abordé dans la vidéo.
- Estimation non paramétrique de densité (Rosenblatt, Parzen, 1956-1962) — Travaux fondateurs de la méthode à noyau, non cités dans la vidéo.
- Règle des k plus proches voisins (Cover et Hart, 1967) — Article fondateur de la règle de classification par vote majoritaire, non cité dans la vidéo.
237 mots
Profil radar
Le profil est celui d'un cours technique équilibré : quantité et qualité d'information élevées, niveau technique soutenu mais accessible, fiabilité globale bonne. Le point faible relatif est l'absence totale de références externes, qui limite la traçabilité sans entamer la validité mathématique du contenu.