Lecture 25 Generalized Delta LR Derivation
Cours 25 Dérivation du Delta LR généralisé
Mots-clés
Résumé
221 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
La valeur informative de cette séance réside dans la progression pédagogique soigneusement construite : l’enseignant part d’un cas concret et visuel, un réseau à deux couches dont on cherche la région d’activation, pour faire émerger la nécessité de la non-linéarité. L’argumentation est de nature constructive : chaque neurone de la première couche est analysé individuellement, son seuil et son poids sont explicités, puis le comportement collectif est recomposé par somme des sorties pondérées. Le raisonnement par énumération de régions, où l’on compte les neurones activés positivement et négativement pour comparer au seuil 3,5, est rigoureux et vérifiable pas à pas. La conclusion — une classe entièrement englobée par une autre, donc non séparable linéairement — est solidement établie par cette méthode. Le passage à la règle delta s’appuie sur une analogie claire entre surface d’erreur et relief topographique, justifiant l’usage du gradient négatif comme direction de mise à jour. L’argument central en faveur de la rétropropagation est également bien posé : l’absence de réponse désirée aux couches cachées rend la règle delta inapplicable directement, d’où la nécessité de propager le signal d’erreur vers l’arrière. La démonstration reste toutefois incomplète dans cette séance, la dérivation étant explicitement reportée.
Rigueur scientifique, qualité des sources, adéquation du titre
La rigueur scientifique est celle d’un cours magistral classique : les notations sont posées clairement (matrices de poids W et V, indices k et j, seuils ordonnés), les étapes de calcul sont explicitées et les hypothèses (activation bipolaire, différentiabilité de la fonction d’activation) sont énoncées. Aucune source bibliographique n’est citée, ce qui est usuel pour ce format mais empêche toute traçabilité vers des travaux de référence. Le contenu correspond aux fondements bien établis des réseaux de neurones, sans affirmation contestable ni donnée empirique à vérifier. L’adéquation entre le titre et le contenu est correcte : la dérivation de la règle delta généralisée est bien le sujet annoncé et effectivement abordé, même si sa réalisation complète est renvoyée à la séance suivante. Aucun commentaire n’étant fourni, aucune analyse des tendances du public n’est formulée.
345 mots
Adéquation titre / contenu
Le titre annonce la dérivation de la règle delta généralisée ; la vidéo traite d'abord un exercice de région de déclenchement d'un réseau à deux couches, puis introduit la règle delta et entame la dérivation de la rétropropagation. Adéquation correcte, bien que la dérivation soit reportée à la séance suivante.
Qualité & fiabilité
7/10
Contenu pédagogique de type cours magistral : les raisonnements géométriques et les formules de la règle delta sont exposés pas à pas et sont mathématiquement cohérents. Aucune source externe n'est citée, mais il s'agit d'un enseignement de notions classiques et bien établies (perceptron multi-couches, rétropropagation). La dérivation annoncée est interrompue en fin de séance, ce qui limite la complétude de la séance prise isolément.
Moments clés
Repères établis par PSI à partir de la transcription : le créateur n'a pas défini de chapitres.
- Annonce de l'exercice : déterminer la région du plan (X1, X2) où le neurone de sortie TLU7, de seuil 3,5, se déclenche.
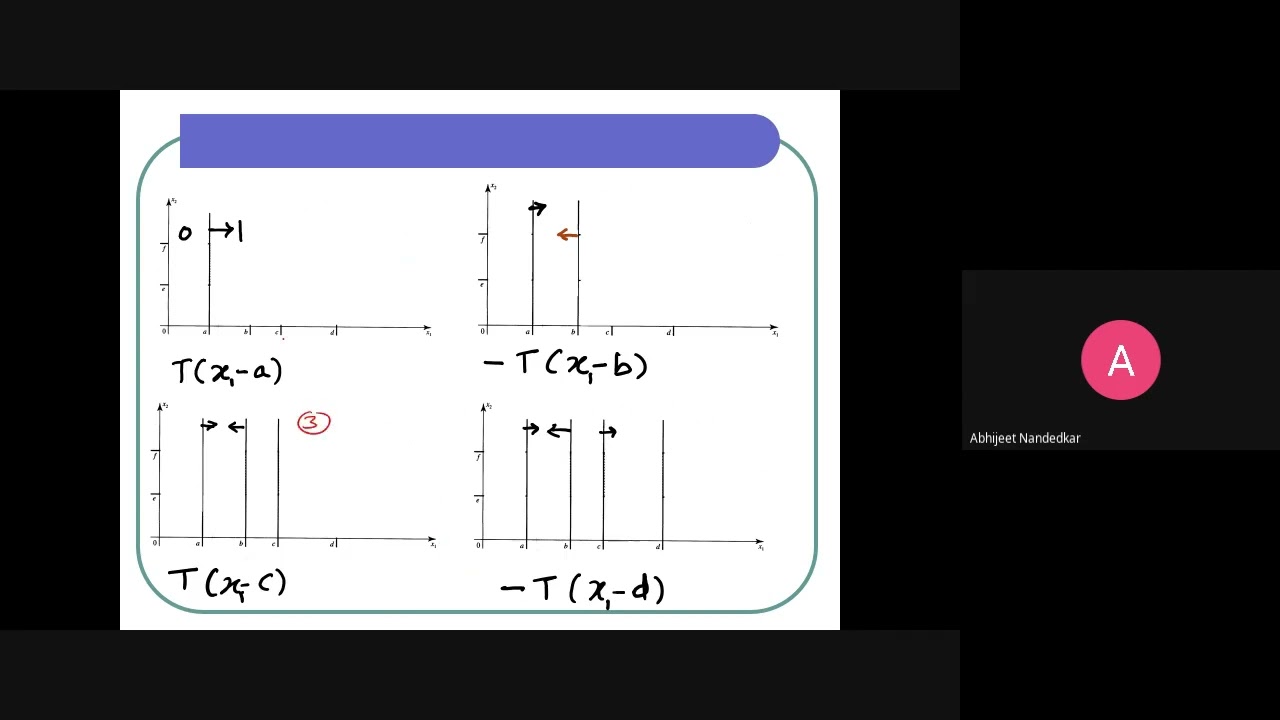
- Analyse du premier neurone de la couche cachée : seuil a, activation lorsque X1 > a.
- Analyse du deuxième neurone : seuil b avec poids négatif, activation lorsque X1 < b.
- Analyse des neurones trois et quatre : bornes c et d encadrant X1.
- Analyse des neurones cinq et six portant sur X2, avec seuils f et e.
- Calcul de la somme des sorties pour différentes régions et comparaison au seuil 3,5 du neurone de sortie.
- Conclusion géométrique : la classe activée est entièrement entourée par l'autre classe, problème non séparable linéairement.
- Rappel de la règle delta : Δw = η·(d−o)·f'(net)·x et interprétation comme descente de gradient.
- Introduction de la rétropropagation : application directe à la couche de sortie, problème des couches cachées sans réponse désirée.
- Définition de l'erreur quadratique et début de la dérivation par la règle de chaîne, reportée à la séance suivante.
Apport & nouveautés
Cette séance n’apporte pas de résultat original mais constitue une synthèse pédagogique articulant deux volets complémentaires : une démonstration géométrique concrète de la non-linéarité d’un réseau à deux couches, et l’amorce de la justification formelle de la rétropropagation. L’intérêt principal réside dans la méthode employée pour l’exercice : au lieu d’invoquer abstraitement l’insuffisance du perceptron simple, l’enseignant fait compter explicitement les activations neuronales région par région pour établir qu’aucune droite ne peut séparer les classes. Le lien établi entre la règle delta et la descente de gradient sur une surface d’erreur, puis l’extension de ce principe aux couches cachées via la propagation arrière du signal d’erreur, fournit une charpente conceptuelle cohérente pour aborder la rétropropagation.
Pour aller plus loin :
- Rétropropagation du gradient — Article de synthèse sur l’algorithme et sa dérivation.
- Perceptron multicouche — Contexte architectural et rôle des couches cachées.
- Descente de gradient — Principe d’optimisation sous-jacent à la règle delta.
- Problème XOR — Cas canonique de non-séparabilité linéaire évoqué dans la séance.
- Apprentissage par rétropropagation de l’erreur, Rumelhart, Hinton et Williams (1986) — Publication fondatrice de la généralisation de la règle delta aux couches cachées.
188 mots
Profil radar
Le profil est celui d'un contenu pédagogique dense et techniquement exigeant : quantité et qualité d'information élevées, niveau technique soutenu, pour une fiabilité solide mais sans références externes. Le léger retrait sur la fiabilité globale reflète l'absence de sources citées et l'incomplétude de la dérivation dans cette séance.