Apprentissage par la machine
Thema UYQM
Strange Geometric Shapes Found Inside AIs — Tom McGrath
D'étranges formes géométriques découvertes au cœur des IA — Tom McGrath
★
★
★
★
☆
4/5
Lec 34: Learning Rate Scaling & Training Dynamics
Lec 34 : Mise à l'échelle du taux d'apprentissage et dynamiques d'entraînement
★
★
★
★
☆
4/5
ANN & LEARNING | DATA ANALYTICS | LECTURE 02 BY MR. MUKULIT GOEL | AKGEC
ANN & LEARNING | DATA ANALYTICS | LECTURE 02 PAR M. MUKULIT GOEL | AKGEC
★
★
☆
☆
☆
2/5
Efficient Deep Learning for Brain Tumor Segmentation
Apprentissage profond efficace pour la segmentation des tumeurs cérébrales
★
★
★
☆
☆
3/5
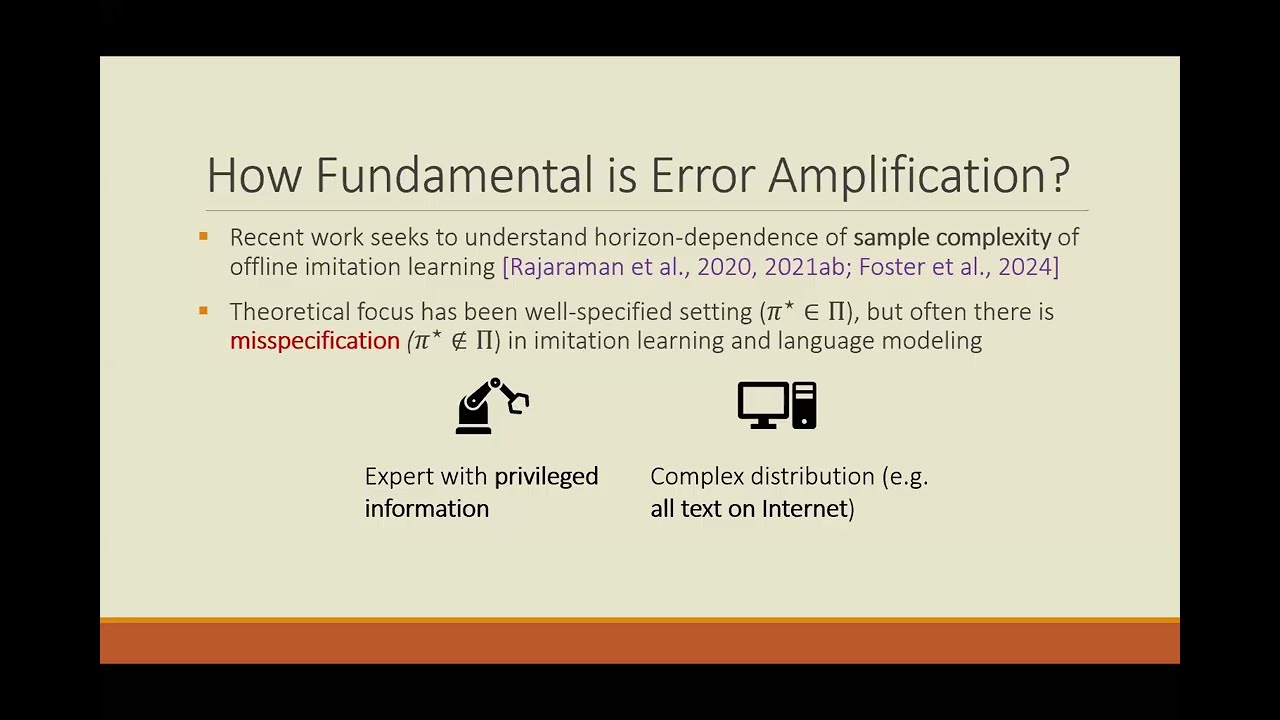
Dhruv Rohatgi: Computational-Statistical Tradeoffs at the Next-Token Prediction Barrier
Dhruv Rohatgi : Compromis calcul-statistique à la frontière de la prédiction du prochain jeton
★
★
★
★
☆
4/5

Ep. 234: How HubSpot Is Reimagining the Entire Customer Journey With AI Agents
Ép. 234 : Comment HubSpot réinvente tout le parcours client avec des agents IA
★
★
★
★
☆
4/5


My PhD Oral Defense Presentation: From Numerical Simulators to Neural Emulators and Back
Soutenance de thèse : des simulateurs numériques aux émulateurs neuronaux et retour
★
★
★
★
☆
4/5


Lec 32: Scaling, Horovod, and Picking the Right Tool
Lec 32: Mise à l'échelle, Horovod, et choisir le bon outil
★
★
★
★
☆
4/5

78. Sonnet 5, Meta Cloud y la guerra de infraestructura
78. Sonnet 5, Meta Cloud et la guerre de l'infrastructure
★
★
★
☆
☆
3/5
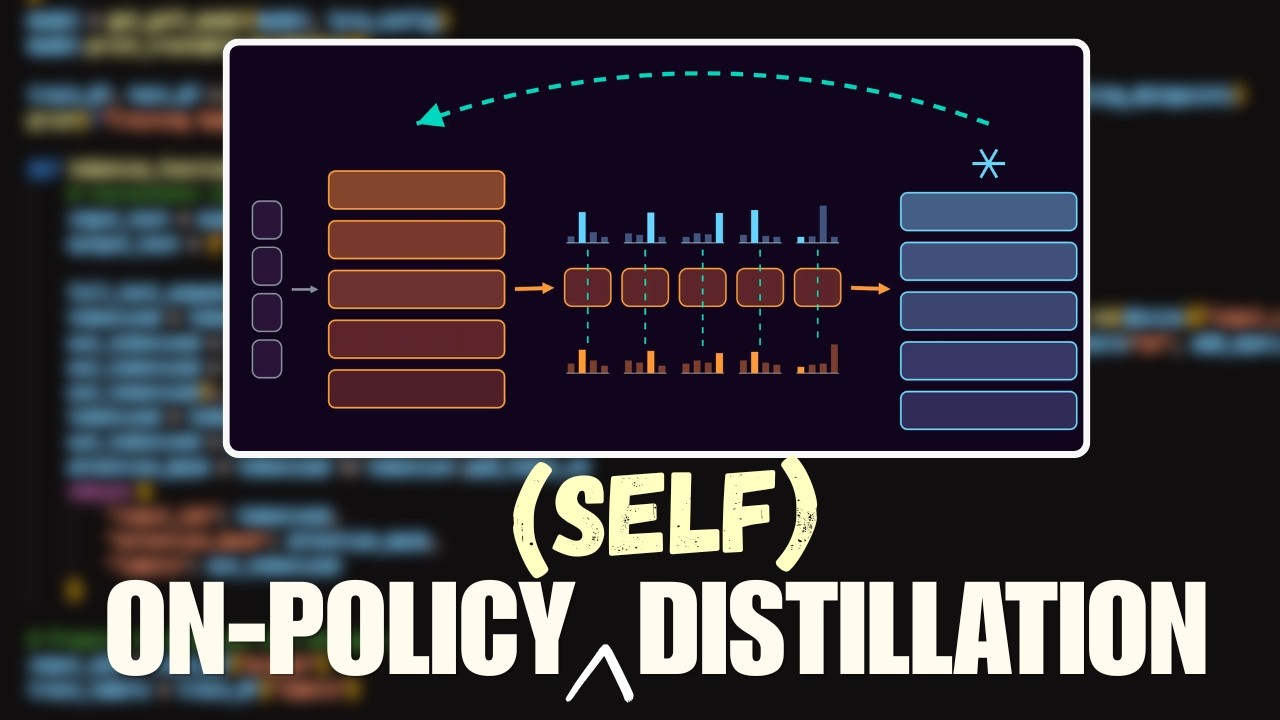
On Policy Distillation - How the big AI labs actually train their LLMs
Sur la distillation de politiques - Comment les grands laboratoires d'IA entraînent réellement leurs LLM
★
★
★
★
☆
4/5
Charla “Minería en Quimio-informática: Cómo extraer compuestos valiosos de bases de datos”
Discussion "Minage en chimio-informatique : Comment extraire des composés précieux des bases de données"
★
★
★
★
☆
4/5
Dr. Boumediene Hamzi | When Compressibility Replaces Smoothness: Bridging Machine Learning, Dynam...
Dr. Boumediene Hamzi | Quand la compressibilité remplace la régularité : Relier l'apprentissage automatique, la dynam...
★
★
★
★
☆
4/5

Code a Reinforcement Learning Library in C from Scratch (Full Course)
Codez une bibliothèque d'apprentissage par renforcement en C à partir de zéro (Cours complet)
★
★
★
★
☆
4/5

I trained a Reasoning Language Model with RL on an unverifiable task
J'ai entraîné un modèle de langage capable de raisonner grâce au RL sur une tâche invérifiable
★
★
★
★
☆
4/5

China Finally Beats MYTHOS 5 With New GLM 5.3 (Plus Anthropic's New Model 2)
La Chine surpasse enfin MYTHOS 5 avec le nouveau GLM 5.3 (et le nouveau modèle 2 d'Anthropic)
★
★
★
★
☆
4/5

Lec 28: Efficient LLM fine-tuning using peft and LoRA
Lec 28 : Ajustement fin efficace des LLM à l'aide de peft et LoRA
★
★
★
★
☆
4/5

Lec 27: Transfer learning for large models
Lec 27 : Apprentissage par transfert pour grands modèles
★
★
★
★
☆
4/5

Dr. Gareth Conduit | Unveil the unseen: uncover hidden information in concrete with machine learning
Dr. Gareth Conduit | Dévoiler l'invisible : découvrir des informations cachées dans le béton grâce à l'apprentissage automatique
★
★
★
★
☆
4/5
Why Great Models Fail: Lessons From 9 Years of Deploying ML Models - Megan Robertson
Pourquoi les grands modèles échouent : Leçons de 9 ans de déploiement de modèles de ML - Megan Robertson
★
★
★
★
☆
4/5
Stanford AA203 Optimal and Learning-Based Control | Spring 2026 | Lecture 19: Model-Based RL
Stanford AA203 Contrôle optimal et basé sur l'apprentissage | Printemps 2026 | Leçon 19 : RL basé sur modèle
★
★
★
★
★
5/5

Stanford AA203 Optimal and Learning-Based Control | Spring 2026 | Lecture 18: RL Policy Optimization
Stanford AA203 Contrôle optimal et basé sur l'apprentissage | Printemps 2026 | Cours 18 : Optimisation de politiques de RL
★
★
★
★
★
5/5

Stanford AA203 Optimal and Learning-Based Control | Spring 2026 | Lecture 17: RL Value-Based Methods
Stanford AA203 Contrôle optimal et basé sur l’apprentissage | Printemps 2026 | Cours 17 : Méthodes basées sur la valeur de RL
★
★
★
★
☆
4/5

Stanford AA203 Optimal and Learning-Based Control | Spring 2026 | Lecture 16: Fundamentals of RL
Stanford AA203 Contrôle optimal et basé sur l’apprentissage | Printemps 2026 | Cours 16 : Fondamentaux du RL
★
★
★
★
★
5/5
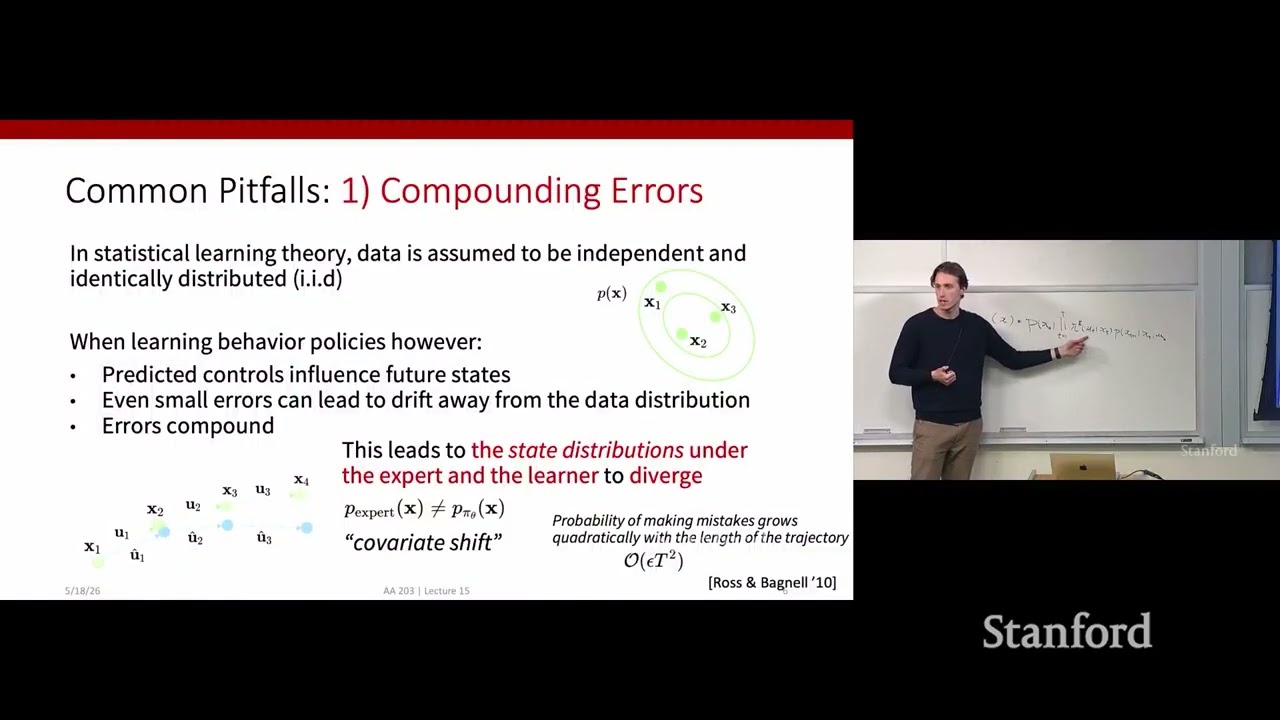
Stanford AA203 Optimal and Learning-Based Control | Spring 2026 | Lecture 15: Imitation Learning
Stanford AA203 Contrôle optimal et basé sur l'apprentissage | Printemps 2026 | Leçon 15 : Apprentissage par imitation
★
★
★
★
★
5/5

Prof. John Harlim | Learning solution operator of dynamical systems with diffusion maps kernel ri...
Prof. John Harlim | Apprentissage de l'opérateur de solution de systèmes dynamiques avec noyau de cartes de diffusion...
★
★
★
★
☆
4/5
Prof. Gitta Kutyniok | Beyond Scaling: Optimization and Learning for Sustainable AI
Prof. Gitta Kutyniok | Au-delà de la mise à l'échelle : Optimisation et apprentissage pour une IA durable
★
★
★
★
☆
4/5

Andrew Lee: Decomposing Query-Key Feature Interactions Using Contrastive Covariances (2026-05-13)
Andrew Lee: Décomposer les interactions de caractéristiques query-key à l'aide de covariances contrastives (2026-05-13)
★
★
★
★
☆
4/5
Fine-Tuning LLMs for Real-World Tool Calling: Lessons from tau2-bench
Ajustement fin des LLM pour l'appel d'outils dans le monde réel : leçons de tau2-bench
★
★
★
★
☆
4/5

Expanding the Capabilities of Tabular Foundation Models
Étendre les capacités des modèles de fondation tabulaires
★
★
★
★
☆
4/5

Enhancing Training Data Pipelines with Lance and the Multimodal Lakehouse
Améliorer les pipelines de données d'entraînement avec Lance et le Lakehouse multimodal
★
★
★
★
☆
4/5